DeepSeek 1017:五项基准齐升,代码 Agent 再上一个台阶
摘要:五项公开基准同步提升,终端、代码与自动化任务都有进展;对照官方同表成绩、前版安全评测和第三方综合榜单,梳理 1017 的能力分布与试用范围。
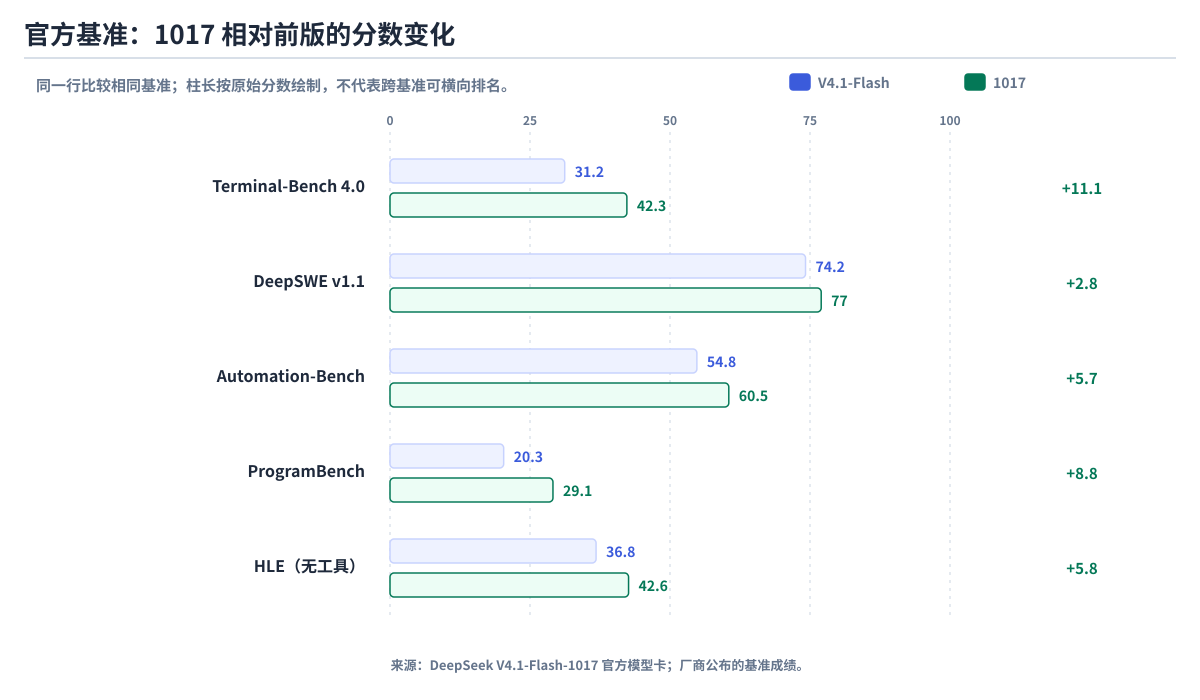
Terminal-Bench 4.0 多了 11.1 分,ProgramBench 多 8.8 分,Automation-Bench 多 5.7 分。三项成绩同时上行,1017 的主要进步落在代码 Agent 工作流。
官方同表显示代码、自动化和视觉任务都有增量;安全数据来自 9 月前版,Vals AI 的综合榜单也早于 1017 更新。后两类不能算作新版成绩。
1017 模型卡未公布 CyberGym、SEC-Bench Pro、ExploitGym 的新版成绩,本文引用的是 V4.1-Flash 前版数据。
代码表现
官方对照中,Terminal-Bench 增幅最大;DeepSWE、ProgramBench、Automation-Bench 与 HLE 也都有提升。
| 基准 | 前版 V4.1-Flash | 1017 | 变化 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| Automation-Bench | 54.8 | 60.5 | +5.7 |
| HLE(无工具) | 36.8 | 42.6 | +5.8 |
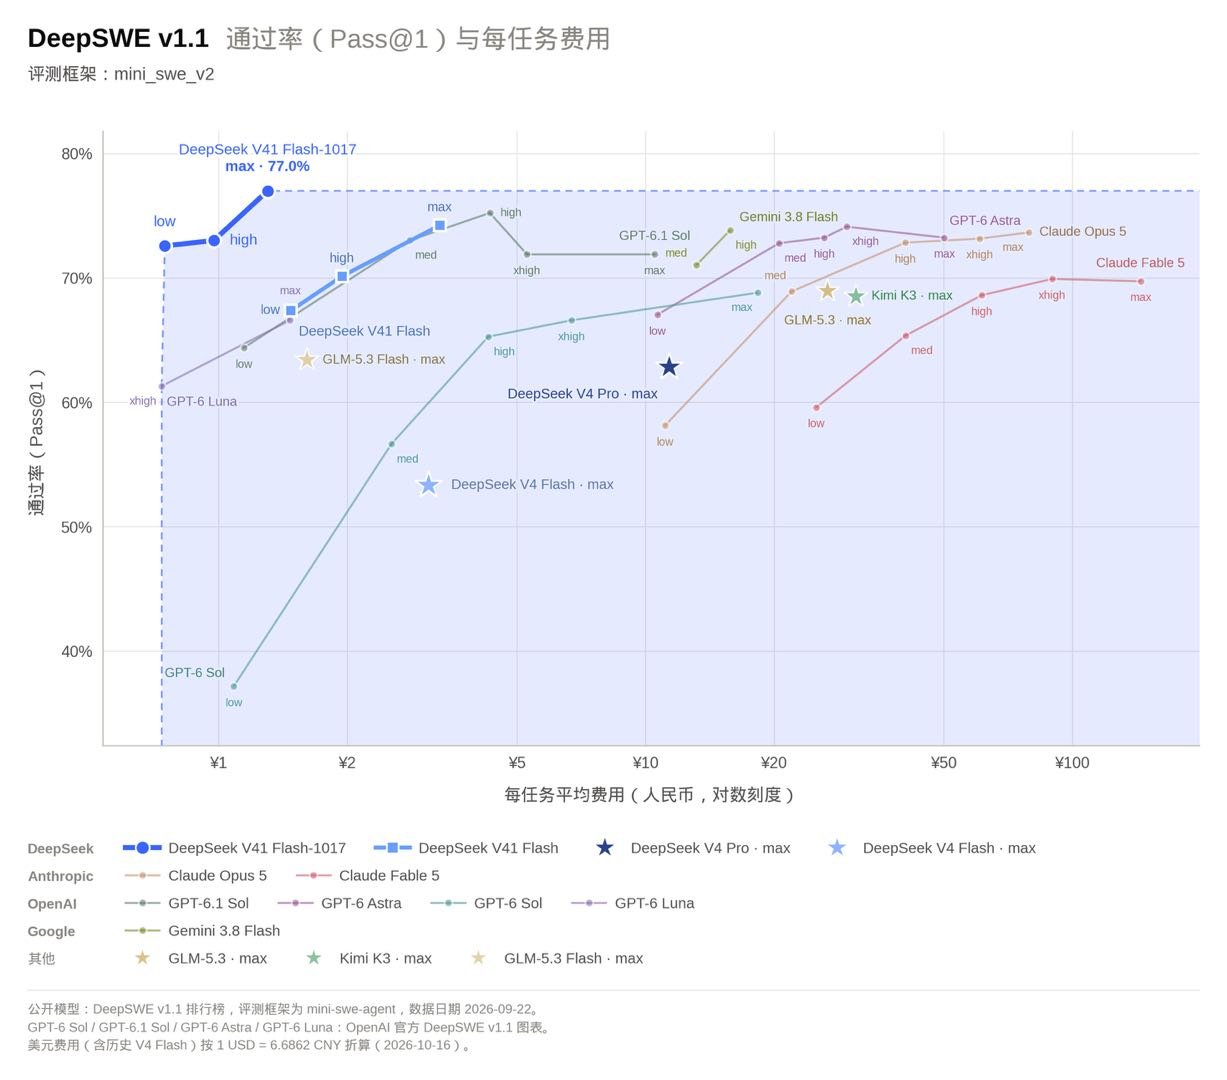
同表比较时,1017 在 Terminal-Bench 4.0 得分 42.3,高于 GPT-5.6 Sol 的 39.9 和 GLM-5.3 的 37.9;Opus 5 得分 51.8。DeepSWE v1.1 上,1017 的 77.0 高于 Opus 5 的 74.0 和 GPT-5.6 Sol 的 73.0。
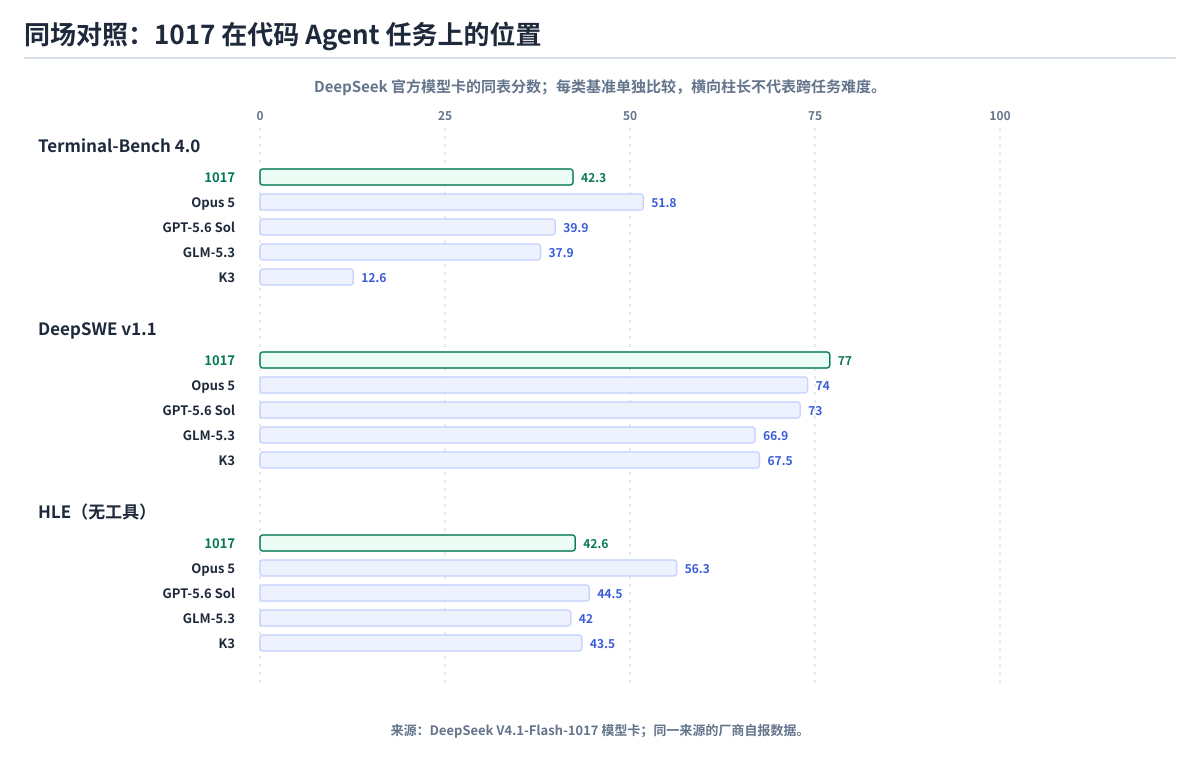
HLE 无工具成绩为 42.6,纯文本子集为 44.0;同表 GPT-5.6 Sol 为 44.5,Opus 5 为 56.3。代码 Agent 是 1017 更占优势的方向,通用推理暂时不是它的领先项。
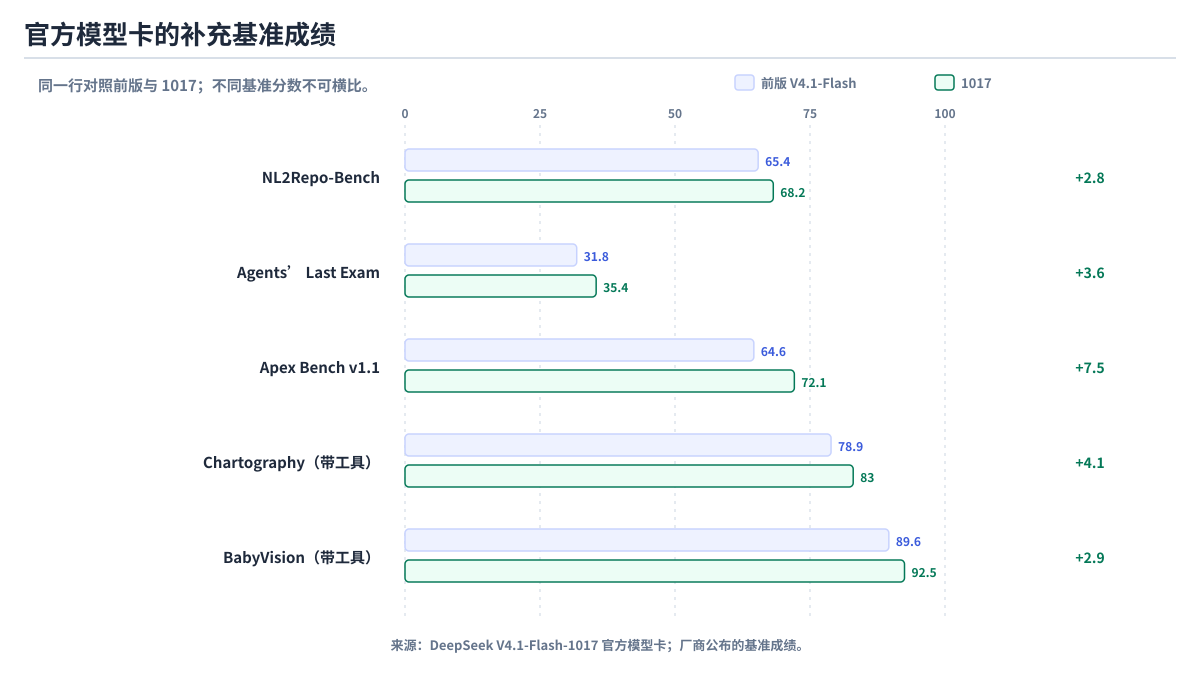
在自动化测试中,Automation-Bench 得分 60.5,高于同表 Opus 5 的 50.3 和 GPT-5.6 Sol 的 45.8;Agents’ Last Exam 为 35.4,高于 Opus 5 的 28.6;Apex Bench 为 72.1,也超过 Opus 5 的 65.8。这几项都来自厂商同表,尚无独立盲测复核。
官方模型卡还列出 NL2Repo-Bench 68.2(前版 65.4),以及带工具视觉测试 Chartography 83.0、BabyVision 92.5(前版分别为 78.9、89.6)。这些分数补充了仓库生成和视觉 Agent 的表现;Chartography 与 BabyVision 仍略低于同表 Opus 5 的 84.0 和 94.1。
成绩条件
这两项基准都在 Agent 框架里运行:Terminal-Bench 4.0 用 Claude Code harness,DeepSWE v1.1 用 Mini-SWE-V2。成绩因此同时受模型、工具、上下文和执行框架影响。
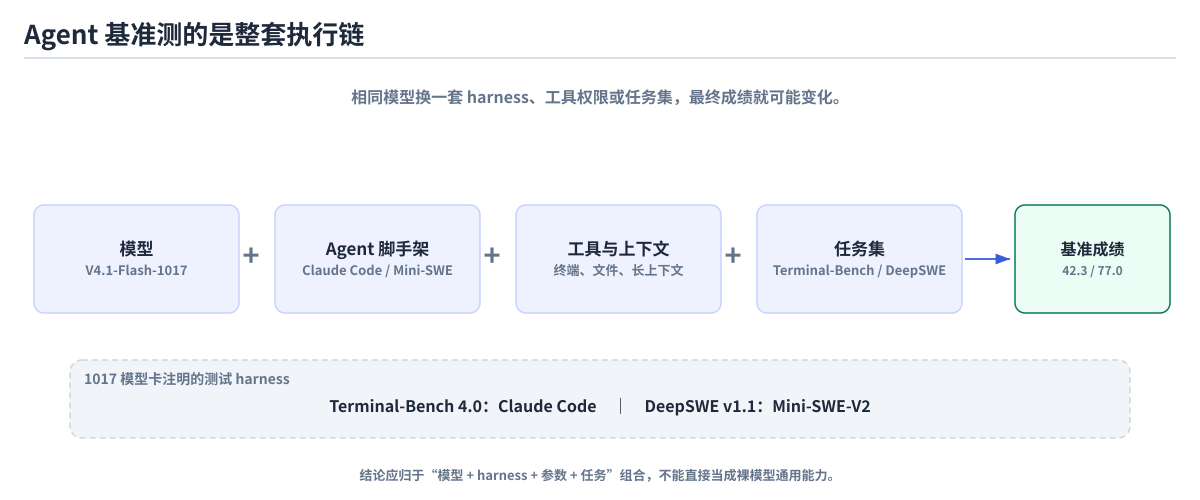
DeepSeek 还称 1017 缩短了运行时间、减少了输出长度,但模型卡没有列出各基准的完整参数、重复次数、平均耗时和任务级 token。读分数时,仍要把对应的 harness 和任务条件一起看。
安全基准
V4.1-Flash 前版的模型卡公布过三项安全成绩:CyberGym 88.1,SEC-Bench Pro 62.8,ExploitGym 15.3,均为 Pass@1。它们不是 1017 的新成绩,官方 1017 对照表没有更新这几项。
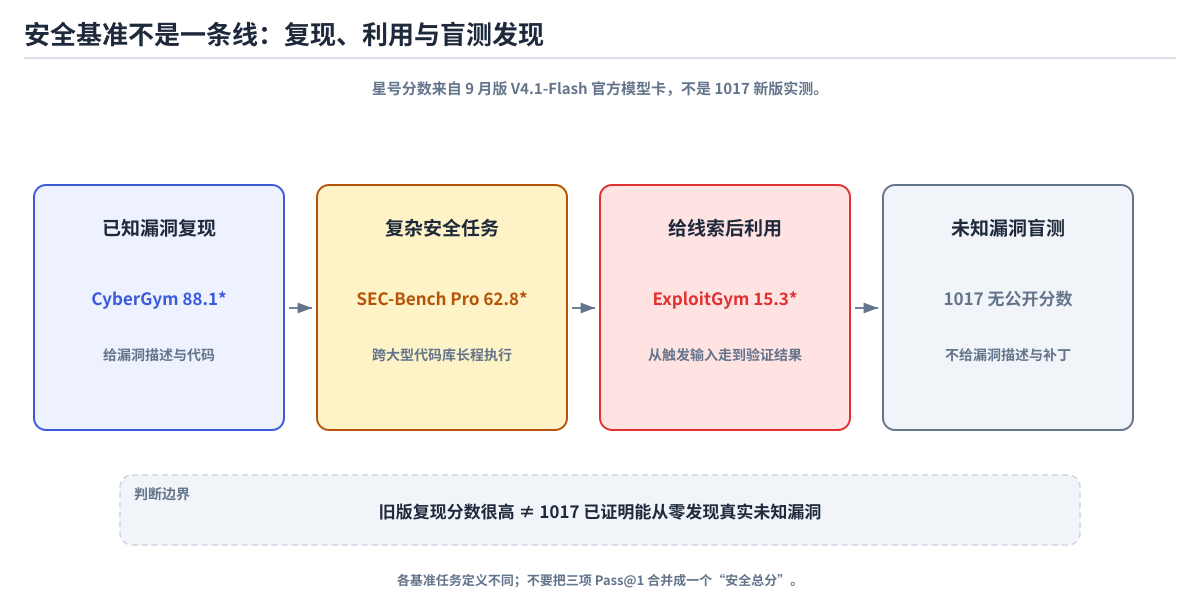
CyberGym 会提供漏洞描述和漏洞前代码,要求模型产出可复现问题的 PoC。88.1 是这类“拿到线索后复现已知漏洞”的成绩,不能读成模型在陌生仓库里自主发现了 88.1% 的漏洞。
SEC-Bench Pro 测复杂代码库中的长程安全任务;ExploitGym 则要求模型从已知漏洞和触发线索推进到可验证的利用结果。三项分数对应不同环节,不能拼成“网络安全总分”。CyberGym 的 88.1 和 ExploitGym 的 15.3 也不能直接相减;两项任务本身不同,但从已知漏洞复现走到利用验证,需要另一类能力。
成本参照
官方 API 单价没有随 1017 上调。峰时与非峰时的输入、输出价格如下,单位均为每百万 token:缓存命中输入 $0.006 / $0.003,未命中输入 $0.30 / $0.15,输出 $1.20 / $0.60。
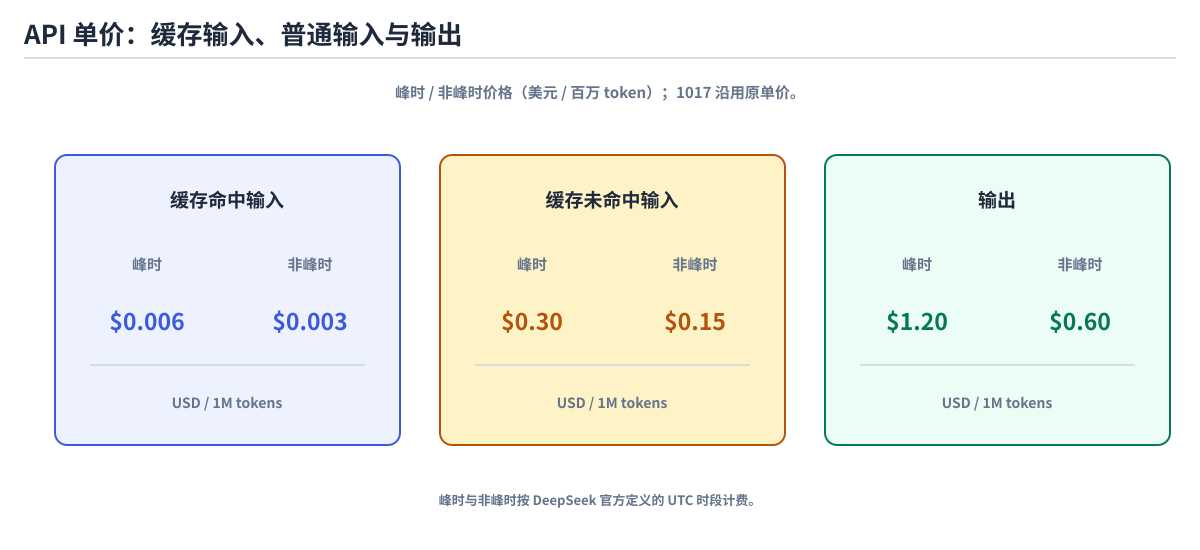
单价低不自动等于任务总成本低。DeepSeek 称 1017 的运行时间和输出长度下降,但没有公布各项基准的任务级 token、平均耗时或账单;实际节省多少,还得看任务成功率、重试次数和输出量。
DeepSWE v1.1 的公开排行榜把 Pass@1 与每任务成本放在同一张图里。图以 2026-09-22 的榜单为底,1017 的 77.0% 点在版本更新后补入;横轴按人民币/任务计价并使用对数刻度,美元费用按 2026-10-16 的汇率换算。同一模型的 low、high、max 设置分布在不同成本和通过率位置,推理设置也要和成绩一起看。这张图适合做公开对照,不等同于所有模型在同一时间、同一配置下完成的复测。
Vals AI 的数据可以作为另一项独立参照,不过最新一条早于 1017 更新。10 月 16 日的综合榜单里,V4.1-Flash 得分 51.32±1.13,排第 26/49;每项测试约 0.33 美元,耗时约 27 分 53 秒。旧 V4-Flash-0731 得分 47.96±1.24,排第 36/49,约 0.85 美元、43 分 6 秒。
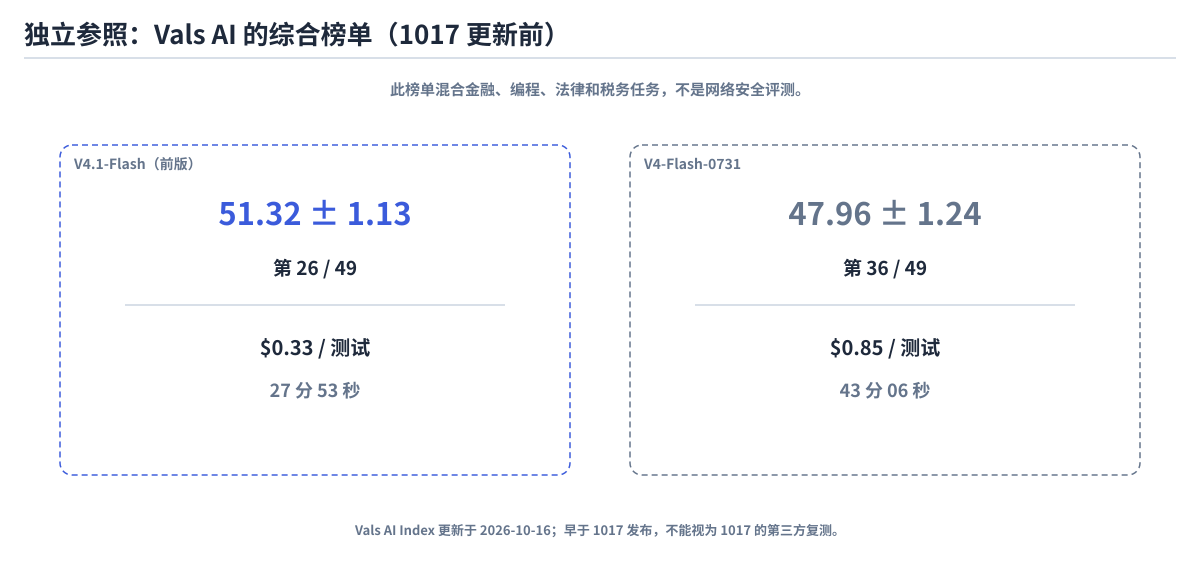
Vals AI 评测覆盖金融、编程、法律和税务,不是安全测试,也没有测到 1017。它说明前版 V4.1-Flash 在综合质量/成本上有竞争力;新版是否延续,还要看第三方复测。
斩杀判据
“斩杀线”不是统一的模型评测术语。我把它分成两层:代码 Agent 基准竞争和安全工作流替代。1017 在几个代码子项达到第一梯队;它能否替代一段安全工作,目前还缺数据。
我们建议把“能否替代一段安全工作”放进盲测里判断:使用同一套脚手架跑至少 30 个未公开任务,再按执行结果和人工复核验收。正确率应不低于现有流程,误报率不超过 5%,每个有效结果的总成本不超过人工基线的三分之一。这个门槛是项目试点建议,不是行业标准。
再往上,要说它能自主发现未知漏洞,任务里就不能附漏洞描述、补丁或已知 PoC;结果必须能在隔离环境里复现,并由独立人员核验。当前没有 1017 在这条线上可复核的公开成绩。
落地建议
1017 在代码 Agent 任务上有多项增量,Terminal-Bench、DeepSWE、ProgramBench 和 Automation-Bench 均高于前版,API 单价也维持原位。安全团队可以先在受控任务中试用它,例如仓库修复、已知问题复现或代码审查辅助,再按团队流程验收结果。公开的安全基准仍是前版数据,不能直接代表 1017。
后续第三方复测若能公布模型快照、harness、任务定义和重复次数,再报告命中、误报、拒绝、token 与耗时,就能把代码基准的提升和安全工作流的实际收益分开衡量。
如果你也在评估 Agent 的安全能力,先把版本、脚手架、任务类型和误报记进试点表,别只留一个总分。
参考资料
- DeepSeek:V4.1-Flash-1017 模型卡、API 更新记录与价格表(2026-10-17)
- DeepSeek:V4.1-Flash 技术报告与模型卡(2026-09-10)
- DataCurve:DeepSWE v1.1 公共排行榜(2026-09-22)
- Vals AI:Vals Index 与 DeepSeek 模型评测页(2026-10-16)
- Wang 等:CyberGym(2025)、ExploitGym(2026);Lee 等:SEC-Bench Pro(2026)