
从源码到 TLA+:Specula 如何生成能找 Bug 的模型(二)
先看两条真实的不变量。Etcd-Raft 要求已提交记录进入多数节点的持久存储;MongoDB 只要求进入内存日志。同源 Raft,检查条件只差一个变量,给出的保证差一档,而且各自都对。生成一条能做出这种级别判断的流水线,就是本篇要拆的东西。
先看整机在哪里
Specula 处理一个并发或分布式系统,走五个阶段。第一篇画过全程地图,本篇只进前两个阶段:代码分析和规约生成。
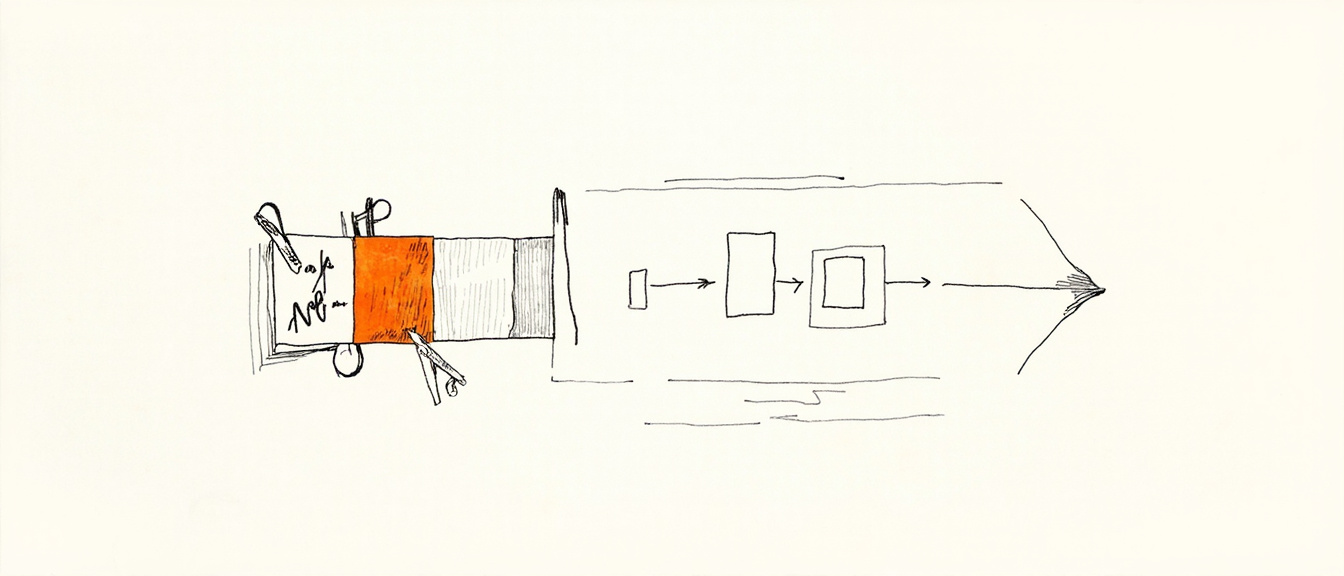
直接让 Agent 读源码写模型是行不通的,细节留多了状态爆炸,砍狠了照不出真实偏差,论文把这称为模型与代码之间的鸿沟。Specula 的替代方案如上图:一条产物接力线,不变量、场景、建模简报、参考模型、场景模型加配置,每个产物有固定格式和证据要求。Agent 在线上工作,不自由发挥。
对错标准从两头取证
不变量是 TLC 判定对错的标准,接力线第一个产物。协议说明与文档给协议级条件;源码、测试、问题单和修订历史给代码级条件,覆盖操作原子性、容量上限、提交位置单调性这类模式。分析只总结系统级行为,API 参数、变量类型这类局部检查不进模型。
开头那对不变量是这样来的。Etcd-Raft 遵循标准协议,条件写作持久 ...
先写证明,再找 Bug:Specula 把形式化验证做成编码 Agent 的流水线(一)
软件里最难抓的一类 bug,只在特定的线程交错、消息顺序或崩溃时序下现身。测试碰到这组条件靠概率,工程上靠日志、超时、重试兜底,兜不住的就成了线上偶发事故。形式化验证走的是另一条路,把系统行为和正确性条件写成数学对象,让工具做穷举检查,测试碰运气的地方,工具把所有可能都走一遍。
形式化验证的运用现状
形式化规约分两部分,模型描述系统允许出现哪些行为,不变量描述每个可达状态必须成立的性质。以并发系统的常用语言 TLA+ 为例,模型写成一组状态变量加一个动作集合,每个动作是一次原子状态更新;工具端的核心是模型检查器,TLC 会穷举模型的所有可达状态,逐个状态核对不变量。发现违反不变量的状态时,TLC 给出一条反例,即从初始状态到违规状态的完整动作序列,每一步做什么、状态怎么变,全部列出来。
这套方法抓并发缺陷有天然优势。libgomp 里有一个真实案例,一个死锁在 GCC 的 OpenMP 运行时库里潜伏了五年以上,触发条件苛刻到需要外部线程恰好在所有其他线程都停进 barrier 等待环之后,才完成一个分离任务(detached task);此时一条唤醒路径漏掉了标记待办任务的调用,被 ...
LLM 徒手改权重:修改 0.016% 参数,数学成绩提升 6 倍
17,253 个权重,是一个神经网络的全部参数,没人说明它被训练来玩哪款游戏。Astra 只看数字,说出答案:Breakout。四个网络、四款游戏,全对。
Qwen3.5-0.8B 的数学成绩只有 7.9 分,病根是思考死循环,93% 的回答写到 32,768 个 token 还在原地打转。Astra 定位病灶,改掉 0.016% 的权重,分数涨到 48.1。
权重全部从零开始,不给数据,不给梯度,不许试跑,Astra 写出一个打 Breakout 的网络,拿 517.4 分。训练了 1 亿步的 PPO 只有 15.8 分。
这三件事出自同一篇论文。MIT CSAIL 团队 11 月 2 日发布《Sparks of Weight-Space Programming》,把这套做法命名为权重空间编程,一句话能说清,让通用的 LLM 绕开优化器,直接读写神经网络的权重。标题里的 sparks 是火花,作者自己留的余地,这是早期信号,不是定论。全文拆开它的 8 个主实验和 1 个附加实验,看它能做什么、怎么做到、哪里做不到。
一条新的优化路径
过去两年,LLM 在深度学习里干的活一步步往深处 ...
Superagent 的自主边界:少打扰人,如何不靠长对话完成长任务
Superagent 的自主边界:少打扰人,如何不靠长对话完成长任务
DeepSeek 公开的 dsh-superagent-prototype 面向一个 GitHub 仓库。获准的用户可以在 Issue 评论中向它提出任务;系统判断后创建工作项,由 Executor 在独立会话和工作目录中处理,再回到原对话反馈结果,例如提交 Pull Request。
这条链路看起来像“@机器人修 Issue”。文章聚焦三件事:谁能派活,一个任务如何接着做,什么时候该叫人回来。README 将它定位为研究原型,提醒用户不要直接用于生产。项目说明
用途定位
dsh-superagent 是围绕代码仓库工作的主动式编程 Agent。它监听 GitHub,也可以选配飞书;收到符合规则的请求后,把任务交给执行会话,最后把结果带回原来的协作渠道。它面向单个 GitHub 仓库,重点是团队的 Issue 和 PR 工作流。
一次任务大致经过“消息进入 → 权限判断 → 建立 Ticket → 执行 → 返回结果”。Ticket 像一张持续存在的工作单,记录任务内容、授权范围和执行状态。Executor 是负责读 ...
Phantom:勒索团伙如何把 AI 接入入侵流程
SOCRadar 的调查把模型、攻击工具、目标知识和人工审批放进同一套工作流。
2026 年 10 月 20 日前后,SOCRadar Threat Research Unit 发布《INC and The Gentlemen Ransomware: Exposed AI Infrastructure》。报告称,研究人员发现与 INC Ransomware、The Gentlemen 关联操作者有关的 AI 驱动入侵生态,并从暴露的攻击基础设施中取得工具、AI 会话记录和行动知识。
公开报道转述的记录包括 133 个 OpenCode 会话、8,257 条消息。它们让 Phantom 有了具体轮廓:攻击者把商业模型接入日常任务,由人类操作员设定目标、审阅步骤,再通过工具链推进工作。
事件披露
SOCRadar 称,团队在暴露的公网服务器上发现 AI 会话、工具和目标追踪记录,并将相关操作者与 INC Ransomware、The Gentlemen 联系起来。
SOCRadar 及其转述将其中一名操作人员描述为俄语使用者。公开材料提供的是语言画像,国籍和国家背景仍未确认。
SOCR ...
一个上传请求打穿 PHP 引擎:php2shell 双漏洞拆解
2026 年 10 月 21 日,PHP 基金会发布了一次计划之外的紧急安全更新,一口气修复两个 CVSS v4.0 评分 9.2 的严重级漏洞。两个漏洞都位于 PHP 引擎内核,都能在无需任何认证的情况下实现远程代码执行。按原计划,细节本应在 22 日随官方公告一起发布。10 月 20 日上午,一个声称 PHP 将有重大披露的帖子出现在 Hacker News,随即被删除,但截图已经在社交网络扩散。PHP 基金会当天拍板:发版提前一天。
这两个漏洞很快被安全圈冠以 php2shell 的代号。watchTowr 的蜜罐网络在补丁发布当天就观测到了利用尝试;Cloudflare 在泄露后看到真实攻击流量,攻击者已经开始针对 WAF 规则变异载荷。
这篇文章把两个漏洞讲清楚:成因是什么,利用链怎么走,影响有多大。先说结论:漏洞不在你的代码里,在 PHP 引擎的请求善后逻辑里。只要服务器在用 PHP 响应 Web 请求,你就是潜在目标,修复只能靠升级 PHP 本身。
口径说明:本文为防御视角的机制拆解,不含可操作的攻击细节。利用可行性区分两类口径:官方安全公告确认的,和安全厂商研究验证的, ...
DeepSeek开源推理“魔法”:DeepInfer与deepseek-recipe拆解
DeepSeek 开源了 DeepInfer 与 deepseek-recipe 两个项目。本文按项目分成两个大章节,分别讲清楚它们是什么、怎样工作、适合解决什么问题,以及代码里有哪些值得用的能力。
DeepInfer 处理模型运行,deepseek-recipe 处理 API 请求、提示词适配和结果解析。deepseek-recipe 是协议与提示词组件,模型计算由调用方提供的推理后端完成。
12一条模型调用链客户端 → API服务 → 请求与提示词适配 → 推理后端 → 输出解析 → 客户端
一、DeepInfer(模型运行时)
项目定位
DeepInfer 是面向 DeepSeek 模型的推理运行时。当前调研的固定版本重点支持 DeepSeek-V4.1-Flash,README 列出 NVIDIA SM100 与 Huawei Ascend 950。它提供 Python 离线推理入口,接收 prompt、运行模型并返回生成 token。
固定版本列出的运行环境包括 Linux、Python 3.12、CUDA 13 或 CANN 9.2,以及较新的编译工具链。DeepInfer ...
《微软2026数字防御报告》解析:AI攻击提速
微软《数字防御报告 2026》同时讨论两类变化。攻击者利用 AI 加快既有攻击流程,AI 系统本身也逐渐成为攻击目标。报告统计 2025 年 7 月至 2026 年 6 月的初始访问路径(攻击者进入目标环境的第一步),用户执行、有效账户、社会工程和钓鱼四类方式合计占 73.3%。
73.3% 统计攻击者进入目标环境时采用的路径,微软没有按生成式 AI 的参与情况拆分。入口数据与 AI 使用案例需要分开理解。报告显示,AI 正在改变攻击速度与自动化程度,账号、用户操作和权限管理仍是防守重点。
统计范围
报告覆盖 2025 年 7 月至 2026 年 6 月。微软称其每天处理超过 165 万亿条安全信号。这个数字反映微软安全产品和威胁情报的观测规模,并非每日攻击数或全球企业的完整统计。其覆盖的用户、终端和云环境会影响能够观测到的活动。
报告摘要将用户执行、有效账户、社会工程和钓鱼四类初始访问方式合计为 73.3%。另一篇 Microsoft Security Insider 解读引用 Microsoft Defender Experts 团队数据,单列用户执行占 30%、有效账户占 20% ...
OpenCode 被黑,用户在替黑客的账单买单
你存在 OpenCode Console 里的 OpenAI、Anthropic、Google API Key,可能已经进了别人的脚本。调用照常发生,额度烧的是你的,账单寄给你。
10 月 17 日,开源编码 Agent OpenCode 官方确认遭遇入侵,1.4% 的 Console 用户当天收到邮件通知:立刻去各厂商后台轮换 Key。
OpenCode 是什么
OpenCode 是一款开源的终端编码 Agent,在开发者社区里热度不低,日常用法是在命令行里让它读写代码、跑命令。Console 是它背后的云端控制台,主要给团队用:把你自己付费的模型账号接进工作区,成员共享这些模型的调用能力,不用各自去申请 Key。
这次出事的是 Console 这条云端链路,纯 CLI 本地用户不在此范围内。这个范围划分后面还会用到,它直接决定你该不该紧张。
经过
官方通知邮件的原话:“We identified unauthorized access to a legacy system that we were in the process of decommissioning.”——出事的是 ...
DeepSeek 1017:五项基准齐升,代码 Agent 再上一个台阶
摘要:五项公开基准同步提升,终端、代码与自动化任务都有进展;对照官方同表成绩、前版安全评测和第三方综合榜单,梳理 1017 的能力分布与试用范围。
Terminal-Bench 4.0 多了 11.1 分,ProgramBench 多 8.8 分,Automation-Bench 多 5.7 分。三项成绩同时上行,1017 的主要进步落在代码 Agent 工作流。
官方同表显示代码、自动化和视觉任务都有增量;安全数据来自 9 月前版,Vals AI 的综合榜单也早于 1017 更新。后两类不能算作新版成绩。
1017 模型卡未公布 CyberGym、SEC-Bench Pro、ExploitGym 的新版成绩,本文引用的是 V4.1-Flash 前版数据。
代码表现
官方对照中,Terminal-Bench 增幅最大;DeepSWE、ProgramBench、Automation-Bench 与 HLE 也都有提升。
基准
前版 V4.1-Flash
1017
变化
Terminal-Bench 4.0
31.2
42.3
+11.1
DeepSWE v1.1
7 ...