OpenAI 破获"蒸馏"攻击:加密的思维链,被模型自己解密了
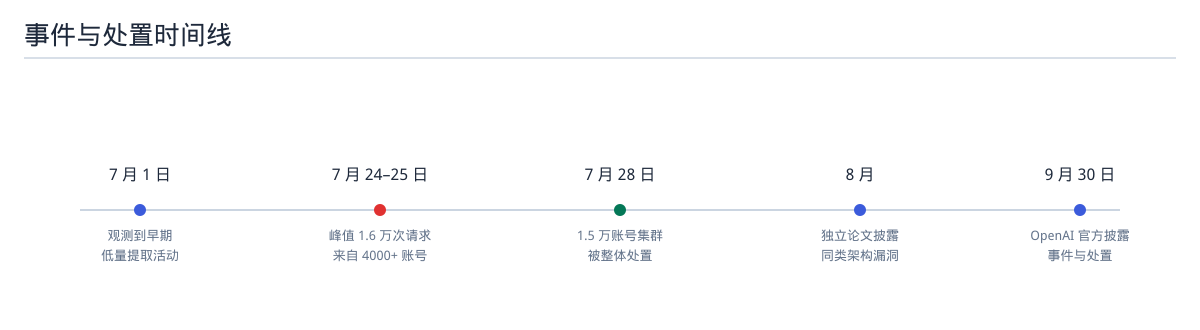
9 月 30 日,OpenAI 在官方博客披露一起已处置完毕的攻击事件。当年 7 月,一批账号以协同方式对其模型发起推理内容提取,7 月 24 日与 25 日出现峰值,两天内产生 1.6 万次匹配同一提取模式的请求,涉及账号超过 4000 个;至 7 月 28 日,关联提问模式所分布的账号集群扩展至 1.5 万个以上,OpenAI 称该集群已被完全瓦解。
事件的目标物并非对话记录或模型权重,而是推理模型的思维链。主流厂商已将思维链列为受保护资产,以密文形态下发至客户端存储。攻击者未对加密机制本身发起破解,而是构造模型交互,使模型自行将密文转写为明文。OpenAI 将该事件的性质界定为对抗性蒸馏(adversarial distillation),即系统性、未经授权地利用一个模型的输出或推理内容训练、复现或改进另一个模型。
全文分四部分:事件时间线、跨会话解密链、风险与响应、归因与证据。
事件时间线
推理模型在生成最终答案之前,会在内部执行多步推理过程,其完整记录即思维链。思维链通常包含最终答案中不可见的信息,如中间推理步骤、候选路径的取舍与被否决的方案。对模型厂商而言,思维链是能力密度最高的产物;对外部竞争者而言,获得高质量思维链数据意味着可以在监督微调或强化学习阶段直接复现目标模型的推理行为,效率远高于从最终答案反向逼近。业界将这类行为统称为蒸馏,此前多起厂商间争议均围绕该概念展开。
OpenAI 披露,7 月 1 日观测到早期低量活动;7 月 24 日至 25 日出现高量峰值,1.6 万次请求呈现一致的提取模式,来自 4000 余个账号;扩大排查后,在同一类提问模式下识别出规模超过 1.5 万账号的关联集群;7 月 28 日,OpenAI 宣布完成对该集群的整体处置。上述规模数字均出自 OpenAI 单方面披露,处置效果无法从外部独立验证。
活动轨迹本身包含结构信息,从低量试探发展到高量并发,提问模式在账号间复制扩散。提取行为已经工具化、流水线化,而非零散的个别用户越界。
跨会话解密链
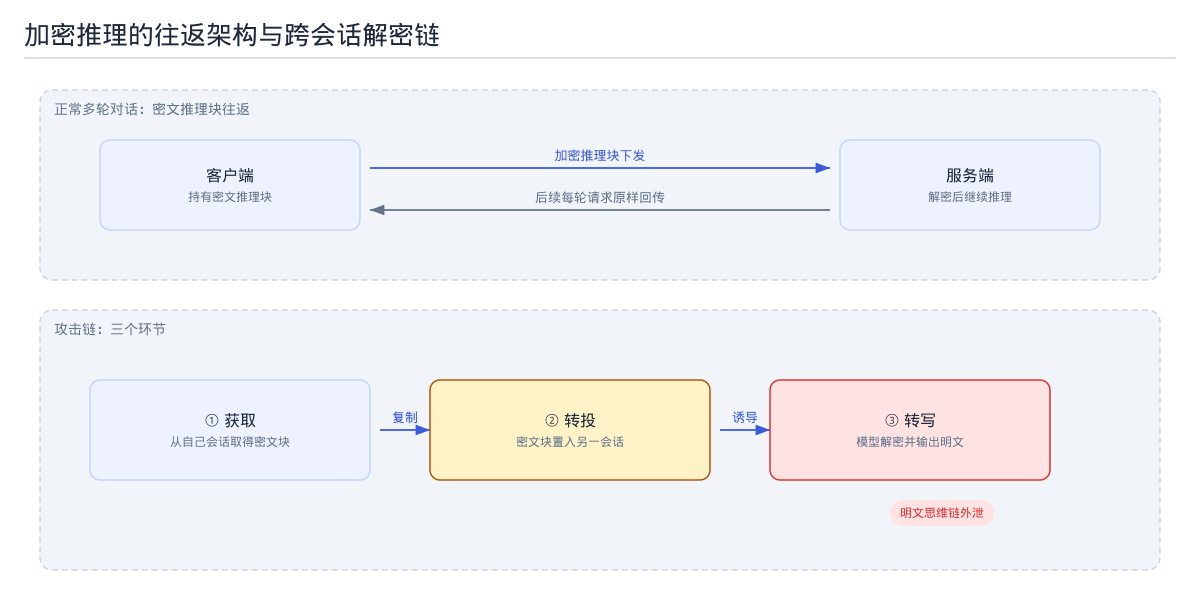
攻击得以成立的前提是思维链的现行保护架构。厂商不将思维链在界面明文展示,也不在服务端以明文长期留存,而是加密后作为数据块返回客户端,由客户端在后续每一轮请求中原样回传,服务端解密后继续推理。以论文拆解的实现细节看,这类数据块是一层带认证的加密信封,头部载明模型名、块类型、版本与密钥编号,其后是随机数、认证标签与密文本体;签名作为关联数据参与完整性校验,厂商据此即可验真并恢复推理状态,全程无需服务端存储。用户在界面上看到的思考摘要只是压缩展示,完整思维链只存在于密文中,这意味着对推理内容的任何审计或脱敏,都必须先经过厂商的解密环节。该架构的动机是避免明文思维链在服务端日志、缓存等环节泄露,并将存储负担与合规责任转移至客户端。由此引入一个未被充分重视的属性,即加密推理块成为可携带、可复放的独立数据工件,其安全性不取决于加密强度,而取决于系统中每一个接受该工件作为输入的环节是否具备同等校验能力。
攻击手法分为三个环节。
第一环节为获取,攻击者从其控制的会话中取得加密推理数据块。
第二环节为转投,将密文块置入另一会话的请求上下文。
第三环节为转写,构造提示使模型将该密文识别为合法的既有推理记录并对其解密,以明文形式完整输出。
攻击全程未触及加密算法,未入侵数据库,未直接读取服务端存储的用户会话;被利用的是系统对推理工件的信任传递链,客户端持有的密文块在各环节被默认视为合法输入,模型交互环节遂成为整条链路上防护最薄弱的一环。
该攻击路径存在独立的学术印证。8 月,一组安全研究者发表论文,系统揭示了此类架构性漏洞,即同一厂商生态内,加密推理块跨会话、跨用户、跨模型完全兼容且可互换。兼容性本为工程便利,使推理状态可随用户在会话与产品间迁移,但工件的通用性同时构成攻击面。
论文的威胁模型划定两类攻击者,前提完全一致,即只需一个普通 API 账号,不接触厂商基础设施,不观测服务端状态,不持有模型权重,全部动作都在标准接口的使用边界之内。
第一类是蒸馏型攻击者,目标是厂商自己的模型能力。攻击者向旗舰模型正常请求推理任务,取得密文块后转投给同厂的轻量型号解码。这里起作用的是模型家族内部的安全不对称,旗舰型号配有专门的拒答训练,防止模型自曝思维链,同门的轻量型号为压低成本、提升响应速度,普遍缺少同等级的反蒸馏防线。密文块跨过这道安全落差,轻量模型就在不知情的状况下充当了解密预言机,强模型的对齐被整体绕开。论文实测,把某旗舰型号的推理签名注入同厂轻量型号并要求后者转写自己的推理,隐藏思维链即被逐字复出,且抽取内容的规模与原模型的思考长度吻合。受测的各厂商生态内,跨模型注入大多能够成立,说明这不是某一家实现上的疏漏,而是同类架构的共同选择所致。
第二类是窃密型攻击者,目标是别人的密文块。开发者出于结果复现的考虑,会把原始智能体会话日志公开到网上,日志的脱敏处理只能作用于明文内容,密文块原样随行;攻击者规模化解析这些轨迹,即可解出其中的 API 密钥、账号凭据与个人敏感信息。论文给出了实例,已公开的解码推理块中存在真实密钥与用户数据。更麻烦的是用户即便知情也难以自救,密文块只有厂商能解,用户没有脱密文的手段,除了整块删除,不存在安全的分享方式。威胁还不止于读取,攻击者可以构造恶意的加密块回注到他人的工作流,污染长程任务的推理上下文。日志公开的复现价值与密文不可脱敏之间存在的这道矛盾,在厂商提供解密或作废工具之前不会有解。
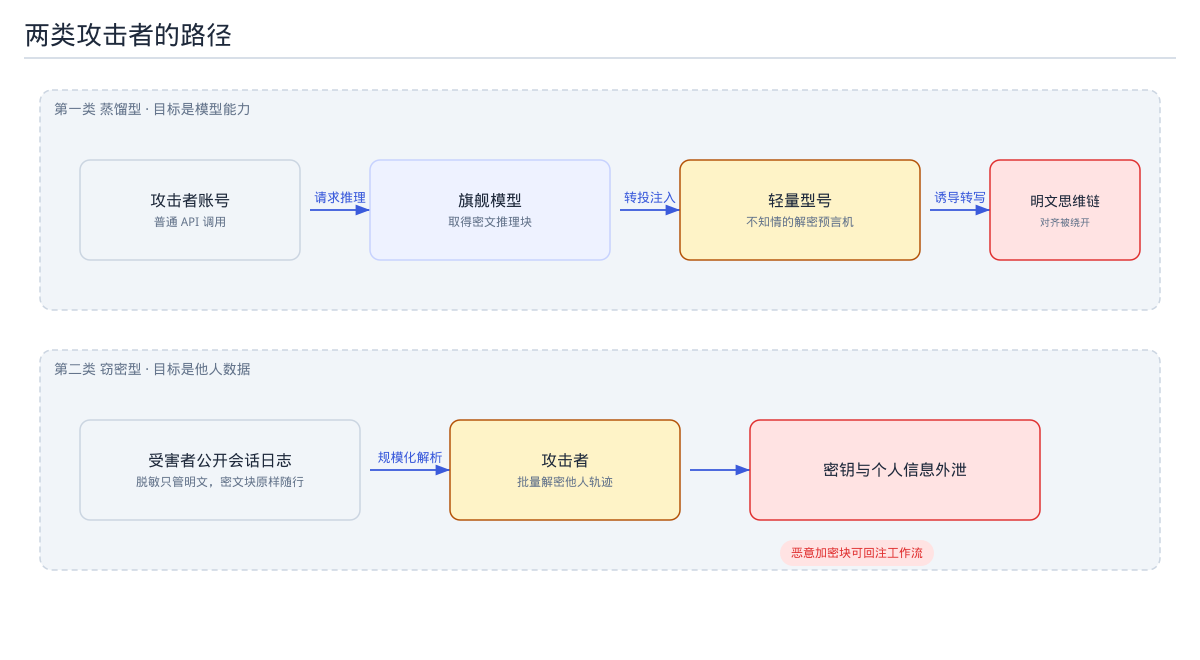
两条路径共用同一个前提,即厂商生态内存在一个兼容的解码模型。对比直接越狱旗舰模型,这条路径的成本与暴露面都低一个量级,全程只是普通 API 调用的组合,这也是它被认为可规模化的原因。该研究团队遵循负责任披露流程,先行向 OpenAI 私下报告跨模型与会话压缩两类相关漏洞,OpenAI 调查后确认攻击路径真实存在,并在此次披露中引用了该工作。OpenAI 同时明确,此类操纵并非其模型独有,相关技术细节已通过行业组织前沿模型论坛同步各前沿厂商,并经政府信息共享渠道通报。
风险与响应
OpenAI 将该事件定性为涉及安全与国家安全的风险,依据有二。
其一,安全约束不随推理内容迁移。模型在面向用户的输出层施加多层安全机制,包括危险请求拒绝、敏感内容过滤与行为边界控制。这些机制作用于最终答案的生成与呈现环节,不内嵌于推理过程本身。思维链中还夹带工具返回结果与用户上下文,泄露面超出模型能力本身,延伸到使用者的数据。推理内容一旦被完整提取并用于训练另一个模型,新模型继承的是推理能力,输出层安全机制需要重建;推理数据中包含模型解决敏感任务的完整决策路径,以之为训练材料生成的模型,其安全基线直接取决于使用者的对齐投入。
其二,能力转移的成本不对称。自主训练前沿模型需要承担高昂的安全对齐投入,蒸馏以远低于自研的成本获取近似能力;模型在双用途领域的能力越强,未经对齐的能力副本扩散所形成的风险敞口越大。
两项依据指向同一判断,事件的严重性不在知识产权层面,而在安全防护体系被系统性绕开的可能。
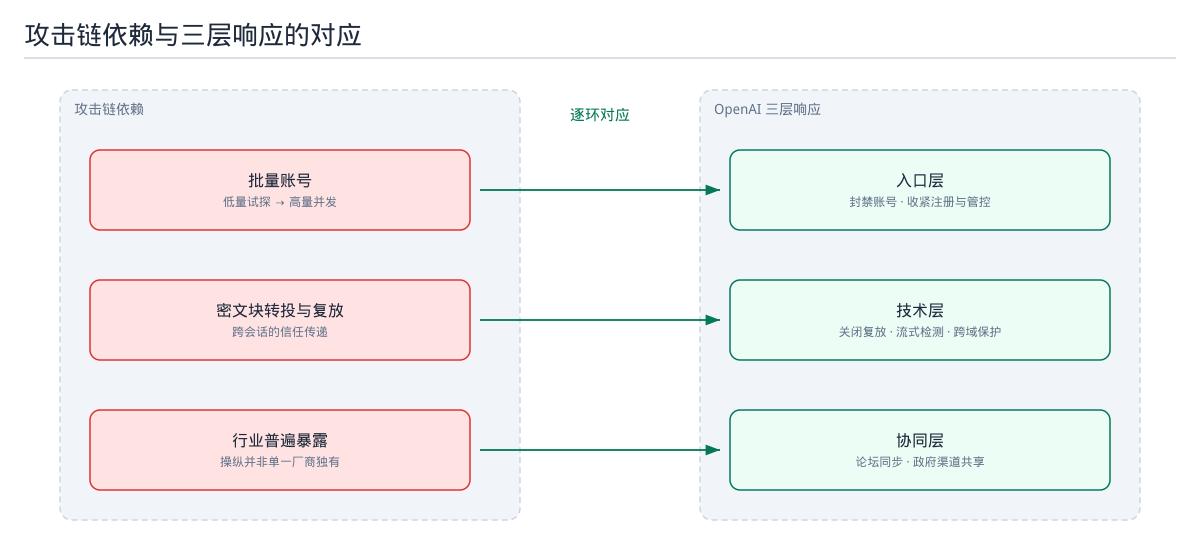
处置措施与攻击链逐环对应。
入口层处置账号供给,封禁与限制涉事欺诈账号,收紧注册流程与基础设施管控,扩展对关联网络的持续监测,直接压缩批量提取所依赖的账号获取能力。
技术层处置解密链路,复放通道已经关闭,此前已持有他人加密推理块的行为者可通过复放请求使模型恢复密文内容;流式输出环节增加检测机制,对可能暴露推理内容的生成结果实施拦截;推理内容的保护边界从单用户扩展至跨用户、跨工作区、跨组织与跨模型族;对经由第三方服务商中转的关联活动,OpenAI 与服务商协作完成定位与处置。该层的实质是切断推理工件在各信任环节的默认可接受性,使密文块的来源与会话绑定。
协同层处置行业面,通过前沿模型论坛与政府信息共享渠道同步攻击特征与处置经验,供其他厂商排查同类活动;后续工作包括强化提取防护、提升对协同性行动的检测与执法能力、深化跨行业与跨政府的威胁情报共享。OpenAI 同时要求,合作方托管的部署需获得与一方服务同等的防护等级,针对工具输出的攻击需要超出可见文本范围的检测手段。
归因与证据
OpenAI 在归因中称,无法确认观测期内全部活动是否源自同一行为者,但其中核心集群来自与 Moonshot AI 有关联的人员。Moonshot AI 为模型 Kimi 的开发方。披露全文未提供支持该归因判断的任何技术证据;率先报道此事的美国科技媒体明确指出证据缺失,并称已向 Moonshot 发出置评请求。截至发稿,Moonshot 未公开回应。
该归因有更早的同类背景。Anthropic 与美国政府方面此前均提出过针对中国公司的系统性蒸馏指控,Moonshot 位列被点名对象,相关指控同样停留在单方陈述层面,未见公开技术证据。本次事件的规模数据与处置效果亦全部来自 OpenAI 单方面披露,不存在外部可验证的第三方口径。
证据强度需分层评估。
机制层面的证据充分,跨会话解密路径获得独立学术研究与厂商确认的双重支撑,属于可复现的架构性漏洞。
归因与规模层面的证据单一,全部关键数据出自指控方自身系统,披露方同时是利益相关方,其归因结论与对外表述服务于自身的安全叙事与政策立场。两个层面应分别采信,不宜混同。
此次披露划出了新的防护边界。推理模型将思维链产品化之后,推理内容成为独立的资产类别与攻击目标;模型安全的对象从输出层的有害内容生成,扩展到推理数据本身的获取、伪造与复放。
参考
- OpenAI:Disrupting a coordinated model-distillation campaign(2026-09-30)
- CyberScoop:OpenAI reveals ‘novel’ encryption bypass used in distillation attack(2026-09-30)
- Panfilov 等:Stealing Reasoning Traces from Proprietary LLM APIs,arXiv:2608.09867(2026-08)
- The Hacker News:OpenAI Disrupts Reasoning Extraction Campaign Linked to Moonshot AI Associates(2026-10-01)