AI安全现况:AI无法保证 AI 的安全
全行业的想象是一个闭环:AI 写代码,写得快;出了漏洞,再让 AI 修;怕它不靠谱,就在提示词里加一句"注意安全"。三道保险,环环相扣,听起来滴水不漏。
这个闭环里的每一环,最近都被人拿数字拆过了。
一个大学团队扫了四万多条安全通告,第一次把漏洞具名归因到 AI 头上;一家密码管理公司的安全实验室跑了六千多次补丁实验,看 AI 修漏洞到底修成什么样;还有两篇互不相识的学术论文,测了"提示词里叮嘱安全"到底有没有用。
三拨人,三种方法,互相不知晓,结论却指向同一个地方:AI 保证不了 AI 的安全。写它的、修它的、验证它的,每一环都比你以为的更漏。
这篇文章把三份账单摆在一起,算一算 AI 代码安全的真实基线到底在哪。
证据一:写——AI 写出的漏洞,已经具名进了漏洞库
先看最直接的一份证据。
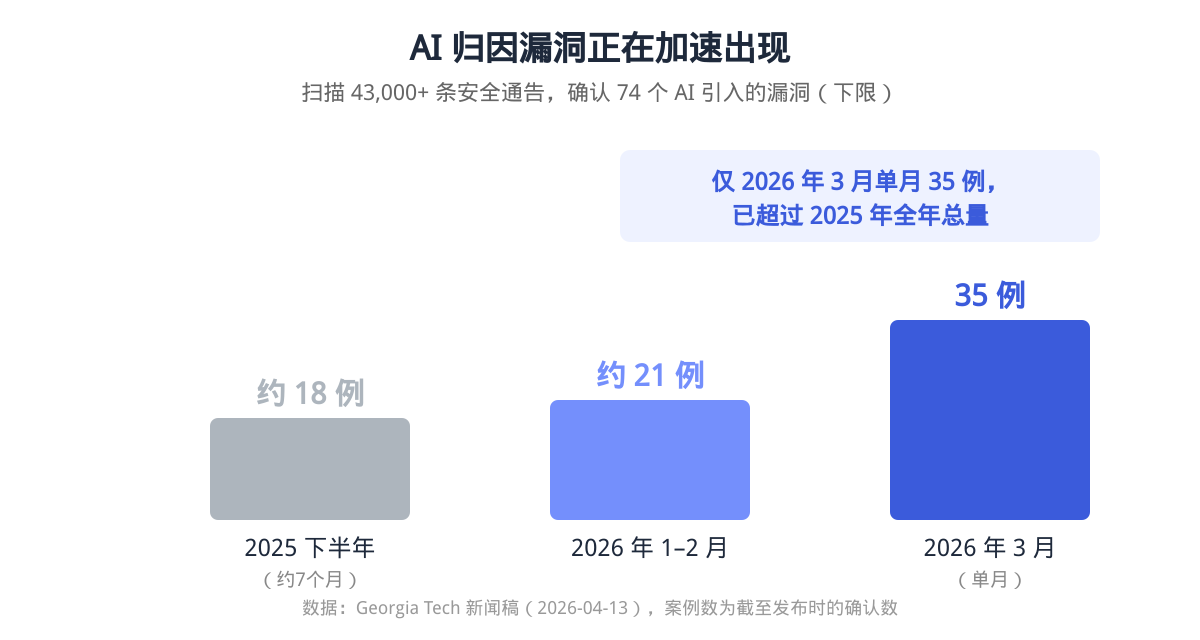
"AI 写的代码不安全"这个说法流传了很久,但大多停留在基准测试和推测里。直到有研究团队换了个思路:不测模型能力,直接去安全通告数据库里数。扫了四万三千条通告,靠提交记录里的机器人署名、协作标签这类元数据,判断哪些漏洞的代码里有 AI 参与。
结果是 74 个。截至发布时确认的 74 个漏洞由 AI 生成引入,其中 14 个是 critical 级,25 个是 high 级。这不是静态数字,曲线还在抬头:仅 2026 年 3 月单月就新增 35 个,超过 2025 全年的总量。
比数量更值得留意的是漏洞的形态。研究者的原话是:当一个 agent 造出一个没有鉴权的东西,那不是手误,是从第一行起就焊死在设计里的缺陷。传统代码评审的直觉是抓"写错",抓不住"压根没写"——没人觉得需要提醒 AI 加登录验证,就像没人提醒同事记得呼吸。
还有一层更少被谈到的风险:模型同质化。几百万开发者用着同几个模型,意味着同一批默认缺陷被批量复制进不同的项目。漏洞不再是一个项目的运气问题,而是全行业的公共底盘问题。
当然要把话说满之前先留一个口子:74 只是下限。归因依赖提交元数据,签名被洗掉就检测不到;而且"Claude Code 和 Copilot 占大头"这个分布,部分原因是它们留下的签名最清晰——工具曝光度高,不等于它最不安全。这两条边界,研究者自己也承认了。
小结第一份账单:生成端的承诺"提效"成立了,"安全"没有。而且漏洞是设计级的、批量复制的,还在加速。
证据二:修——让 AI 自己修?一半以上是"带病修理"
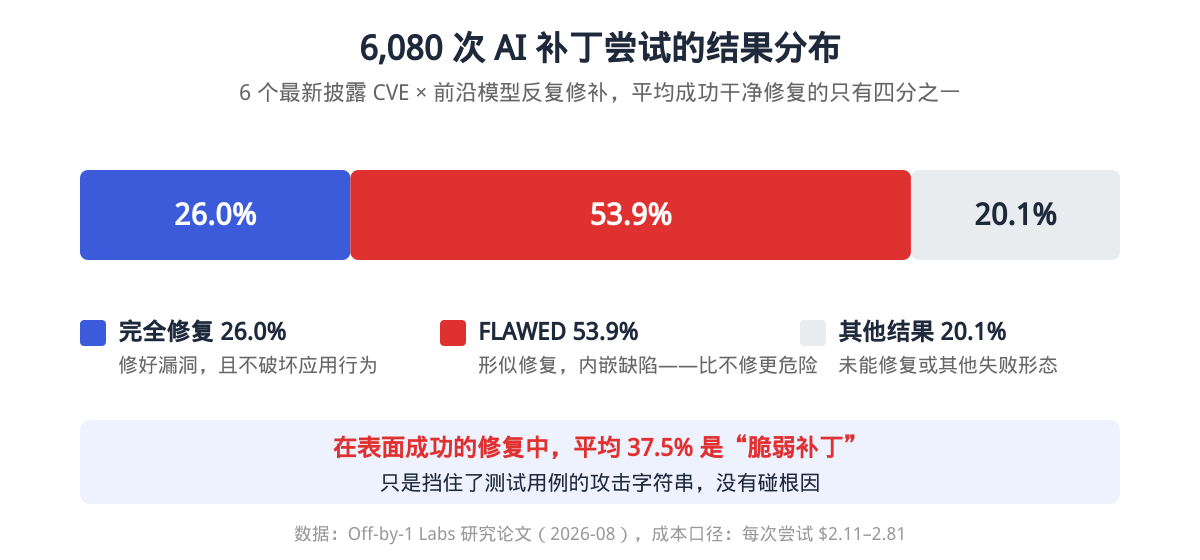
写出来的漏洞,那就让 AI 修掉,这是闭环的第二环。一家密码管理公司新组建的安全实验室决定实测这一环,他们挑了 6 个最新披露的真实 CVE——不是陈年旧题,是刚公开、攻击窗口正开着的洞——让前沿模型反复修,一共跑了 6,080 次补丁尝试。
结果分三层,一层比一层难看。
第一层:真正"既修好了漏洞、又不破坏应用行为"的干净修复,只有 26.0%。
第二层:53.9% 的产出被归为 FLAWED——看起来像修复,里面嵌着新缺陷。这类补丁的可怕之处在于,它比不修更危险:不修,所有人知道洞还在;修"好"了,所有人以为洞没了。它制造的是已修复的假象,让人放心地放弃检查。
第三层最讽刺:即便在那些"成功修复"里,超过三分之一也藏着脆弱点——平均 37.5% 的表面成功的补丁,实际只是挡住了测试用例里的攻击字符串,没有真正碰根因。验证集写什么,它就"修"什么。这是评测时代的经典陷阱在新场景复活:考什么背什么,考完就忘。
实验还顺手算了一笔经济账:每次补丁尝试加验证,成本在两到三美元。便宜,便宜到可以无限重试;但失败的代价不在这两三美元里——在于你根本不知道哪一次"成功"是演出来的。
需要说明口径:这是安全厂商自己团队的实验,不算完全独立第三方。但它把数据集和工具全部开源,并请了外部研究者评审,方法摆在明面上,谁都可以复跑。
第二份账单的结论:修复环节的兜底也不成立。而且失败的方式不是"修不动",是"假装修好了"——这恰恰是兜底最坏的形态:不是暴露风险,是掩盖风险。
证据三:防——提示词叮嘱和自动扫描,双半盲
前两环都漏,那就上第三道保险:写提示词时叮嘱一句"注意安全",再让扫描工具把把关。几乎所有企业的 AI 编码安全指南,第一条都是这么写的。
两篇学术论文,把这条指南打了回去。
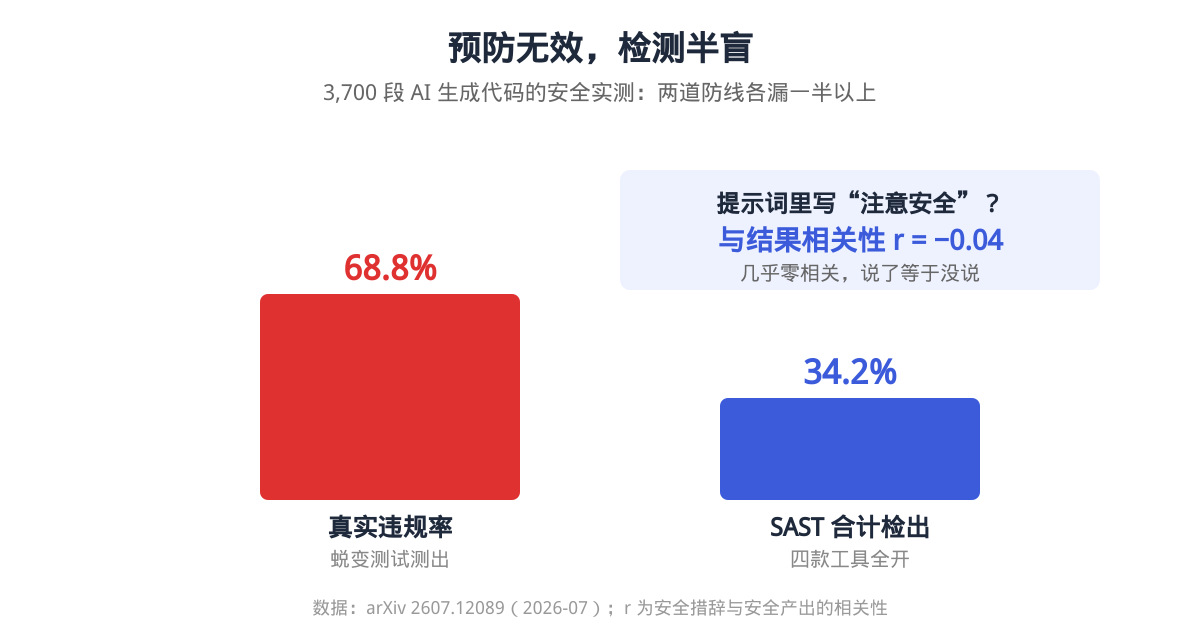
第一篇用蜕变测试的方法给本地开源模型出了 3,700 道题:生成的代码里,68.8% 至少违反一条安全规则;在出现凭据的片段中,79.1% 直接硬编码。然后是全文最关键的一个数字——提示词里明确要求 secure,与实际结果的相关性是 r = −0.04。
几乎零相关。统计上,说了等于没说。
第二篇从另一个角度切:四种提示方法各生成四千个文件、合计一万六千个,卡方检验的结论是各方法之间,漏洞频率和密度没有统计学上的显著差异。两篇论文方法不同、模型也不同,结论一致:安全提示词是安慰剂。
更有意思的是一个叫"提示条件化"的现象:65.5% 的提示任务,在五个不同模型上产出了方向一致的违规结果。该出事的题,换哪个模型都出事。问题不在模型的品格,在任务描述里那些没写出来的隐性前提。
那不靠叮嘱,靠工具呢?研究者把四款主流静态扫描工具全开,合力只抓到了 34.2% 的真实违规——约为蜕变测试测出的一半。预防无效,检测半盲,两个缺口叠在一起,才是 AI 代码安全的真实基线。
适用范围照旧要标注:第一篇只测了本地开源模型,没有闭源前沿模型,且规则判定用了大模型当裁判,本身有偏差;第二篇用的模型偏老。方向结论可信,具体数字外推要谨慎。
合论:三个缺口拼出同一张图
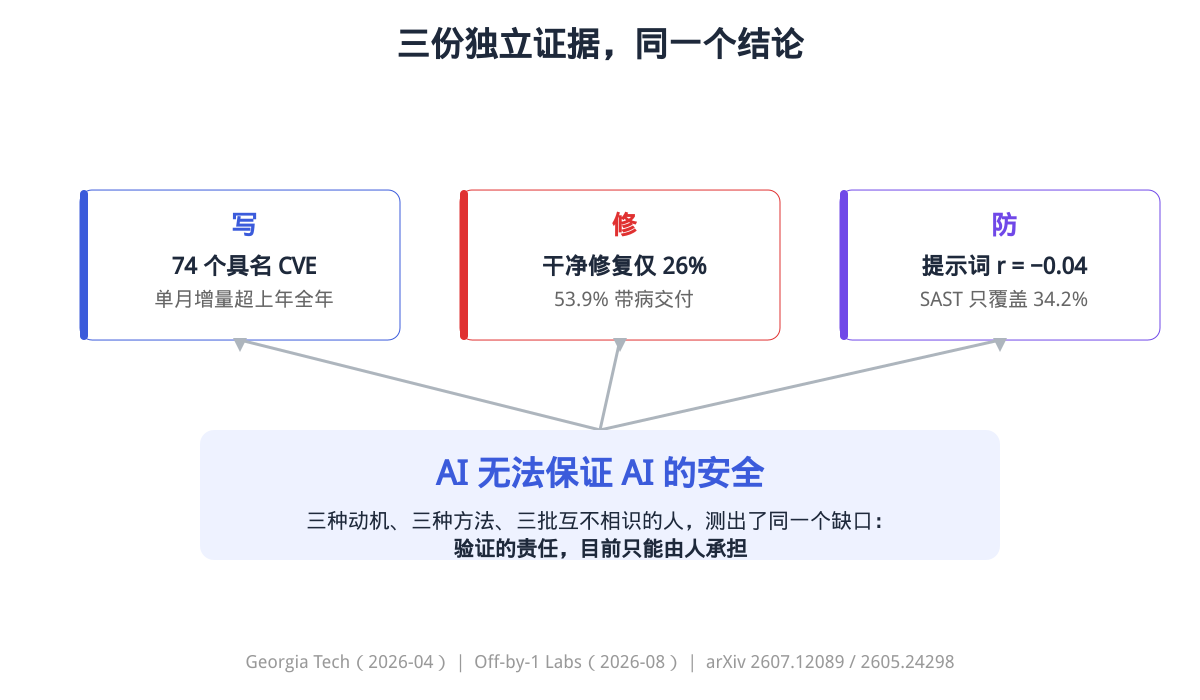
现在把三份账单并排放:
- 写:四万三千条通告里数出 74 个具名 CVE,单月增量超上年全年
- 修:六千零八十次实验,干净修复率 26%,一半以上带病交付
- 防:提示词相关性零效应,扫描工具只覆盖真实违规的三分之一
这三份证据的价值,不全在数字本身,而在"独立"两个字。一个是大学的数据库归因,一个是厂商的红队实测,一个是学术界的受控实验,动机、方法、对象都不一样,却在同一个论点上会师。单看任何一份都可以抬杠,三份叠在一起,抬杠的成本就太高了。
它推翻的是那个流行的乐观叙事:“AI 的问题让 AI 解决”。这个叙事在每个环节都有一版——写漏了让 AI 修,修不好靠提示词,提示词不灵再等下一代模型。三份账单说明的是:这个循环的每一环都不是自动闭合的,中间缺的那块,叫验证,而验证目前只能由人来做。
所以落点不是悲观,是分工。从三份账单里能带走的实操结论有三条:
一,独立验证不可省。AI 起草、人定版,验证这一步必须是另一个独立视角——可以是另一个模型,可以是另一套工具,但不能是它自己。
二,把"要求"升级为"门禁"。安全责任从提示词里挪出来,放进 CI 流水线:生成后强制扫描,扫描不过不许合并。提示词是请求,门禁才是约束。
三,警惕"已修复"的假象。验证集太窄,就会奖励那些只会挡测试字符串的脆弱补丁。修没修好,不能只看测试过没过,要看根因动没动。
AI 把写代码的成本打到了地板上,但验证代码的成本一分没降。在三份账单合上之前,这句话值得每个团队算进自己的成本表:省下的钱是真实的,迟早要还的债也是。
来源清单
- Georgia Tech 新闻稿《Bad VIBES》(2026-04-13): https://news.research.gatech.edu/2026/04/13/bad-vibes-ai-generated-code-vulnerable-researchers-warn ——43,000+ 通告扫描、74 个确认案例(14 critical + 25 high)、2025 下半年约 18 例 vs 2026 前三月 56 例(3 月单月 35)、monoculture 与归因偏差表述。⚠️ 唯一可引来源为该校新闻稿,无独立原始论文;74 为"confirmed cases so far"
- 1Password Off-by-1 Labs 博客(2026-08-06): https://1password.com/blog/why-ai-generated-patches-still-require-human-review + 研究论文 PDF(frontier-models-vulnerability-patches-flawed.pdf)+ 仓库 https://github.com/Off-by-1-Labs/FLAWED ——6 个 CVE、6,480 次生成(6,080 有效)、S1–S5 细分(26.0/20.1/49.3/2.3/2.2,出自论文 Table 7)、干净修复 26.0%、FLAWED 53.9%、fragile 占 S1+S2 平均 37.5%(论文 Table 19)、成本 $2.11/$2.81
- arXiv 2607.12089《Cross-Cutting Security Analysis of LLM-Generated Code via Metamorphic Testing and Association Rule Mining》(2026-07-13): https://arxiv.org/abs/2607.12089 ——3,700 片段、68.8% 违规、硬编码凭据 79.1%(适用片段内)、r=−0.04(原文"negligible correlation")、SAST 34.2%、65.5% 提示条件化
- arXiv 2605.24298《An Empirical Evaluation of LLM-Generated Code Security Across Prompting Methods》(2026-05-22): https://arxiv.org/abs/2605.24298 ——四方法 × 4,000 文件合计 16,000、χ² 检验、提示词方法无显著改善