DeepSeek开源推理“魔法”:DeepInfer与deepseek-recipe拆解
DeepSeek 开源了 DeepInfer 与 deepseek-recipe 两个项目。本文按项目分成两个大章节,分别讲清楚它们是什么、怎样工作、适合解决什么问题,以及代码里有哪些值得用的能力。
DeepInfer 处理模型运行,deepseek-recipe 处理 API 请求、提示词适配和结果解析。deepseek-recipe 是协议与提示词组件,模型计算由调用方提供的推理后端完成。
1 | 一条模型调用链 |
一、DeepInfer(模型运行时)
项目定位
DeepInfer 是面向 DeepSeek 模型的推理运行时。当前调研的固定版本重点支持 DeepSeek-V4.1-Flash,README 列出 NVIDIA SM100 与 Huawei Ascend 950。它提供 Python 离线推理入口,接收 prompt、运行模型并返回生成 token。
固定版本列出的运行环境包括 Linux、Python 3.12、CUDA 13 或 CANN 9.2,以及较新的编译工具链。DeepInfer 围绕列出的模型和设备组织 kernel、缓存与调度;部署前要核对模型、驱动、CUDA/CANN 和设备型号。
使用者通常从 LLM.generate() 开始。调用代码可以很短:
1 | # 示意伪代码:具体参数以对应版本示例为准 |
调用发生在 Python 程序里:LLM 会建立 LLMEngine,由调度器组织请求,再交给 Worker 和 ModelRunner 执行模型前向、采样与后处理。示例配置还会解析 Hugging Face 模型 ID 或本地目录,并设置设备可见性。使用者需要自行把网络请求接到这段推理入口。
prompts 可以是一组待处理文本,sampling_params 则控制生成长度和采样方式。调用方拿到的是模型生成结果,后续可写入评测文件、交给下游程序,或包装成自己的 API 响应。这个入口把模型运行直接放进 Python 工作流里,省去先搭建网络服务的步骤。
执行链路
一次生成通常分成 prefill 和 decode。prefill 把整段输入 prompt 读入模型,建立生成阶段要复用的状态;decode 再逐步产出 token。长 prompt 会增加 prefill 工作量,长回答会让 decode 连续占用设备。前者通常影响首 token 等待,后者关系到后续生成速度。比如让模型先阅读一份长文再回答,阅读阶段对应 prefill;模型开始逐字生成总结后,进入 decode。两个阶段消耗不同,调度器才需要分别安排。
调度器要在不同请求之间安排这两类工作。它维护 waiting 和 running 请求,还要看输入长度、批次容量和显存余量。DeepInfer 的 C++ scheduler 也协调数据并行组里的多个 rank(执行单元):同组 rank 往往要保持相同的计算步型,否则集体通信可能无法对齐。
代码设有 ALL 和 ANY 两类投票点。ALL 要求每个 rank 都有待处理输入,减少部分设备空等;ANY 则允许只要一个 rank 有请求,全组就进入 prefill,避免少数请求被长时间晾在队列里。调度器随后再次检查资源,因为序列槽位和 KV 块可能分配失败。若所有 rank 最终都没有请求排入,就退回 decode,避免空 prompt step 连续发生。
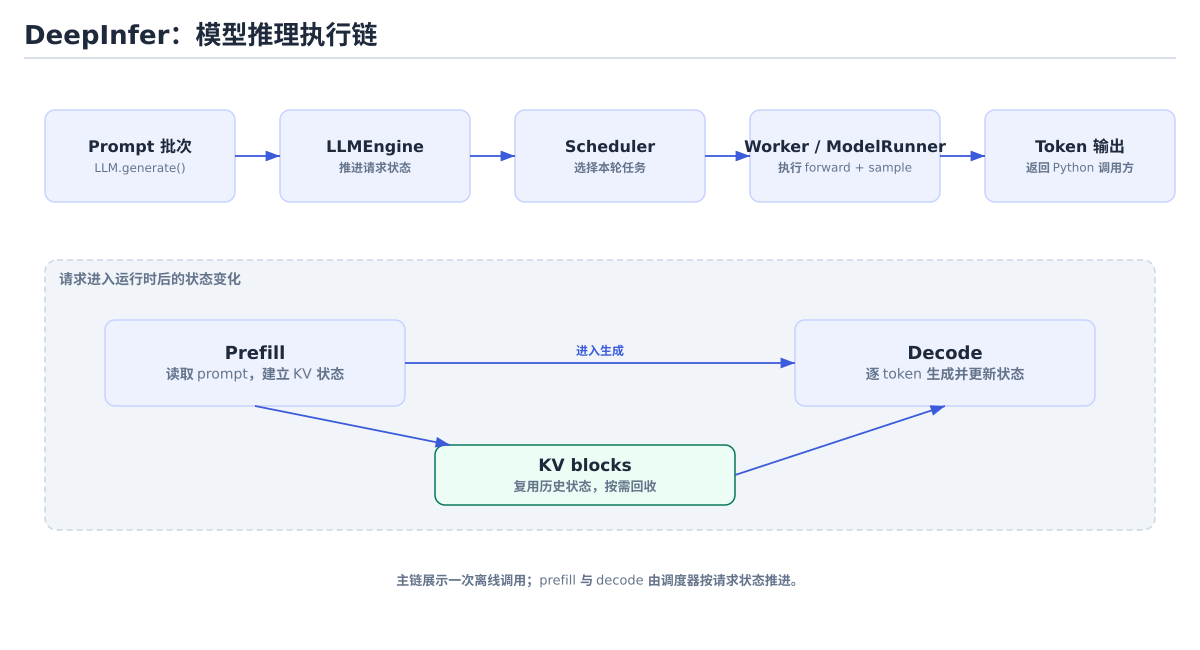
这张图把调用入口、引擎、调度器、Worker 和 token 输出连在一起。下半部分单独画出 prefill、decode 与 KV blocks 的关系:prefill 建立状态,decode 持续读写状态,序列完成后相关缓存才能回收。
下面的伪代码把调度循环再压缩一层。真实实现还包含多 rank 同步、缓存申请、抢占和异步后处理,这里只展示请求如何被分批推进:
1 | # DeepInfer 内部调度循环的简化示意 |
这条链路的每一段都能在代码里找到对应实现:LLM.generate() 提供 Python 入口,LLMEngine.step() 推进请求状态,C++ scheduler 选本轮任务,Worker/ModelRunner 执行 forward 和 sample。研究者可以沿着调用路径定位等待、调度或模型执行方面的问题。
缓存与抢占
KV cache 保存模型生成时要反复使用的历史状态。没有它,每生成一个 token,模型就得重新计算大量已处理过的上下文。DeepInfer 的本地代码确实有 KV 管理:Worker 初始化 GPU cache,CacheEngine 分配压缩后的 KV blocks 和序列状态,C++ BlockManager 维护空闲块和引用计数,序列通过 block table 记录自己占用哪些块。部分状态还会配合 SWA 或压缩 ring buffer 保存;请求 fork/clone 时,管理器按引用关系决定什么时候能回收资源。
图里把 KV 状态画成书签,表示后续生成可以沿用上下文状态,省去重复读取整段 prompt。
DeepInfer 的 KV block 管理运行在单个推理进程内。README 把完整 inference service 所需的 “A KV cache system” 列为未包含项,但没有说明它是否指共享、持久化等服务级缓存能力。仓库中的进程内 KV 管理仍然存在,两处描述涉及的层级不同。
显存不足时,调度器还会抢占请求。普通请求可以清掉当前 KV 状态、重新排队计算;正在执行结构化输出约束的请求,当前实现无法安全重建约束状态,可能以 FINISHED_PREEMPTED 结束。显存压力有时会直接终止请求,响应变慢只是另一种表现。
优化机制
DeepInfer 在推理热路径里提供几种针对性优化,分别处理不同负载。实际收益取决于请求、模型和设备。
ZOS(zero-overhead scheduling) 把部分前一步后处理延到下一轮,再利用 CUDA event 和异步释放安排工作重叠。设备继续跑当前批次时,CPU 可以收尾上一批结果,减少两边互相等待。
MTP/DFlash 用于投机解码。draft head 先提出一段候选 token,再由主模型批量验证;通过的 token 可以一次接受,遇到分歧则从错误位置继续。DeepInfer 的变长调度根据各序列前一步的 confidence,估算连续接受多个 draft token 的可能性,再结合实测 forward 和 sampler 耗时,决定本轮验证多少 token。草稿质量高的请求可能得到更多验证预算;这里的 confidence 仅作调度输入,没有经过概率校准。
可以把它想成同时校对几份草稿:一份草稿的前几词得到主模型认可,系统可以继续验证后续候选;若较早出现分歧,就缩短该请求的验证长度。候选仍由主模型校验,最终接受多少 token 取决于请求。
EPLB(Expert Parallel Load Balancing) 面向混合专家模型(MoE)。模型会根据 token 路由到不同 expert;如果流量集中在少数专家,最忙的设备可能拖慢整个 step。EPLB 统计各层 expert 收到的 token 数,为热点 logical expert 增加 physical replica,再把副本分到不同 rank,尽量降低设备间负载峰值。
路由器仍把 token 指向同一个 logical expert,EPLB 则可将该专家的 physical replica 放到不同设备分担计算。它调整的是模型并行中的专家负载。
YoCo/SWA bounded replay 让符合模型结构的层少重放一部分 prefill query,同时保留滑动窗口和回退所需的尾部 token。该路径只适用于匹配的模型层。README 配置用 140 个 token 描述保留尾部,实际值仍需覆盖 SWA window 和最大 backtracking 长度。项目示例核验 compact 与 mask 模式,并检查兼容 checkpoint 的 logprob 与 top-K 一致性。
DeepInfer 还提供 batch-invariant 与 deterministic sampling 设置。batch-invariant 试图减少同一请求因 batch 组成不同而出现的输出差异;deterministic sampling 还要固定随机种子,并关闭 MTP 变长分配。它们处理的是不同来源的输出变化。
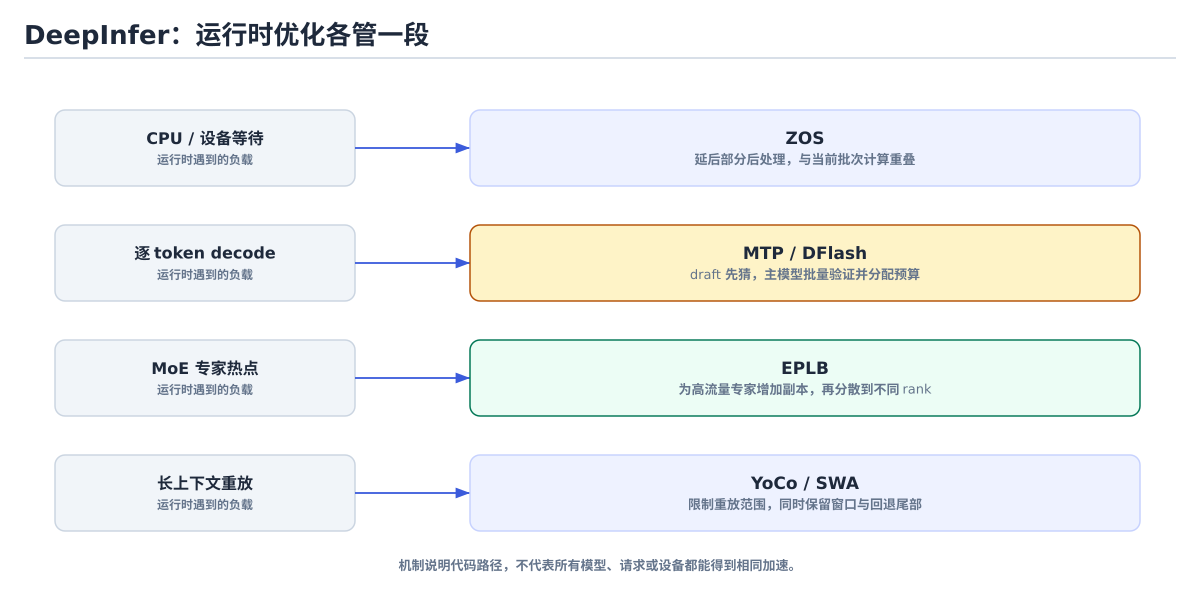
图中把每种机制对应到它处理的运行时负载:ZOS处理CPU与设备的等待,MTP/DFlash处理逐token解码,EPLB处理专家热点,YoCo/SWA处理受支持模型的重放范围。源码能说明它们怎样工作,实际加速仍要用目标模型、设备和请求测量。测试时应固定模型版本和硬件,记录输入长度、输出长度、并发量与采样参数;否则不同请求组合的耗时很难直接说明是哪项优化带来的变化。
用途与优点
DeepInfer 适合离线批量生成、V4.1-Flash 模型验证、特定 GPU/NPU 上的推理优化,以及研究调度、MoE 负载和 speculative decoding 等运行时机制。模型工程师可以用固定 prompt 检查权重或采样配置的改动;运行时工程师可以观察批次、KV 块和并行设置如何改变执行路径;硬件适配人员可以检查模型专用 kernel 与设备支持。
它的主要优点是能深入运行时内部。调度器如何组织 prefill/decode、KV 块怎样分配、专家副本如何部署、投机解码怎样分配验证长度,都能从项目代码追踪。Python 入口降低了离线实验门槛,硬件专用路径则让团队有机会围绕目标模型调整底层执行。
长 prompt 的首 token 等待过长,可以检查 prefill 调度;长输出吞吐不理想,可以观察 decode 批次和 MTP;MoE 负载不均,可以查看 EPLB 统计与布局。沿着代码定位这些部件,能看清耗时出在哪一段。使用者仍要理解目标模型、显存布局和并行配置,并验证各项开关在目标环境中的作用。
DeepInfer 的开源版本重点在离线推理。要把它用作在线服务后端,还需外接 HTTP API、认证授权、请求排队、取消与超时、监控和集群扩缩容。它适合模型与系统团队做底层推理工作,不应直接当成完整的生产 API 服务。
创新优化小结
从这份源码看,DeepInfer 最值得关注的运行时改进有四项:
- ZOS:把一部分后处理延后一轮,与当前计算重叠,减少 CPU 与设备的等待。
- MTP/DFlash 变长验证:按草稿接受信号和实测耗时分配验证预算,不给每条请求固定长度。
- EPLB:针对 MoE 热点专家创建物理副本并重新布局,缓解设备间负载峰值。
- YoCo/SWA bounded replay:在受支持的模型层减少 prefill 重放,同时保留窗口和回退所需状态。
这些是代码中实现的优化机制;实际加速效果以目标环境的基准测试为准。
二、deepseek-recipe(协议适配组件)
项目定位
deepseek-recipe 是一组 Rust 组件,负责把不同 API 请求转换成 DeepSeek V4/V4.1 模型需要的会话与提示词,并解析生成结果。它支持 Chat Completions、Responses 和 Messages 等协议路径。项目本身不执行模型 forward,具体推理由调用方提供。
仓库把请求协议、核心会话、模型编码、图像处理和流式解析拆成不同 crate。开发者可以把需要的组件嵌入自己的 Rust 服务,也可以参考 Python FastAPI 或 Rust Axum 示例了解接入方式;不必把整个仓库作为独立服务部署。
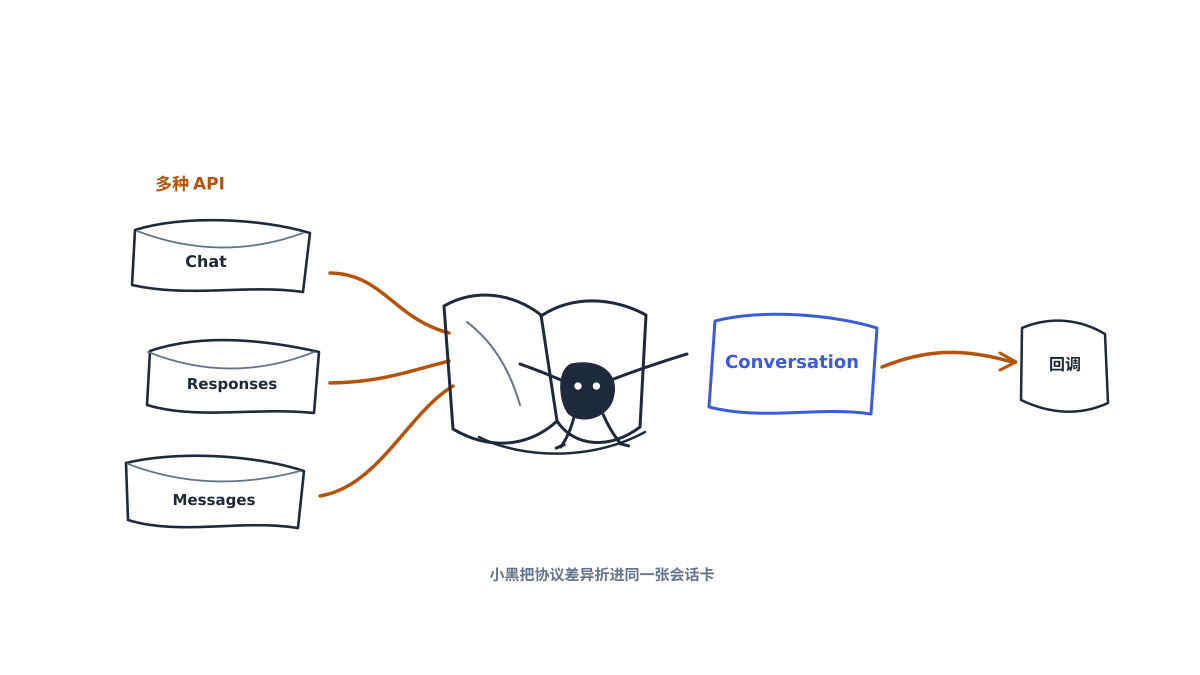
图里的小黑把不同形状的请求纸片整理成 Conversation,再交给调用方的推理回调。它概括的是协议归一过程,模型计算仍在回调接入的后端执行。
请求流程
收到请求后,recipe 会先校验字段、解析模型别名、转换消息与工具定义,再把温度、最大 token 数和输出约束整理进 InferenceOptions。会话本身会归一为 Conversation,之后按模型版本渲染 prompt。准备好的输入交给调用方提供的推理回调,生成结果再进入流式解析器。
1 | # deepseek-recipe 请求处理示意伪代码 |
例如,客户端把 messages、工具定义、max_tokens 和 streaming 开关放在不同协议字段里,recipe 会先把消息与工具归一,再把采样参数交给推理回调。回调不需要自己解析每个客户端的原始 JSON;输出阶段再由 parser 把生成内容包装成对应的响应事件。
默认模型名称会映射到 V4 Pro 或 V4.1-Flash;无法识别的名称会被拒绝,应用也可以配置别名。max_tokens 等限制要在 prompt 编码后核算,因为输入 token 数和图片都会占用 context budget,影响后端可生成的上限。
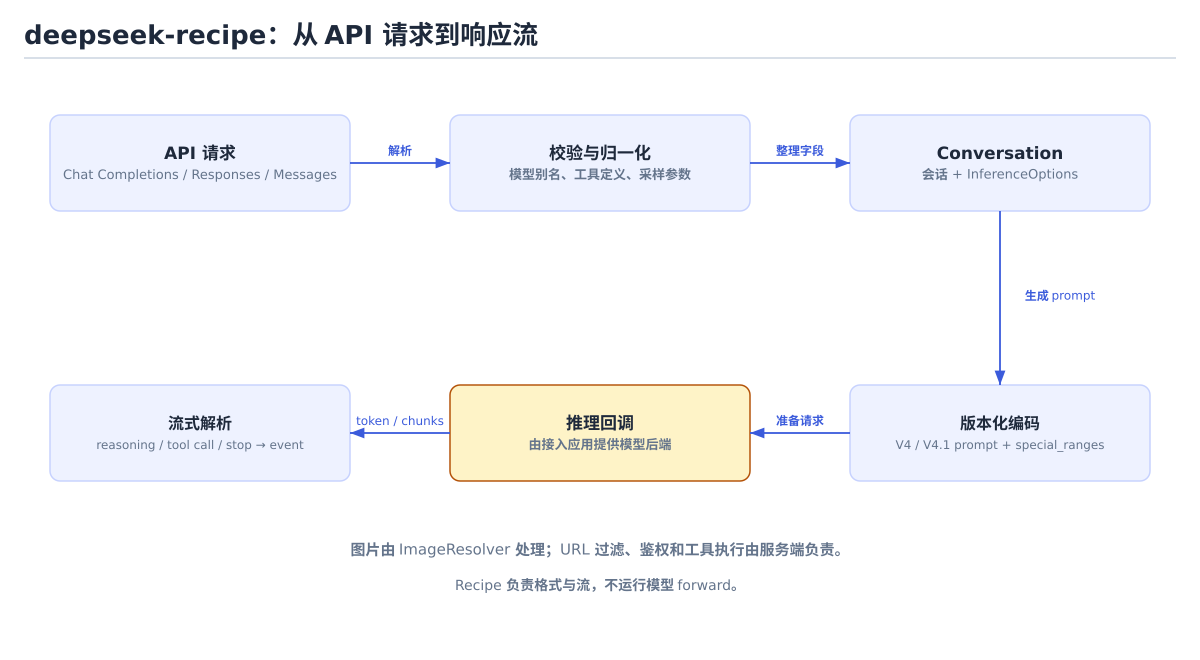
上图从 API 请求开始,经过字段归一、Conversation、版本化编码,交给应用提供的推理回调,最后解析输出流。图片 URL 会进入 ImageResolver;鉴权、工具执行和实际模型计算仍由接入服务决定。
编码与输出
Recipe 针对 DeepSeek 版本处理 prompt 编码。V4 与 V4.1 使用不同的 encoding,渲染结果还带有 special_ranges,标记模板插入的控制 token 区间。用户消息中即使出现 </think> 这样的字面字符串,tokenizer 也应把它作为普通内容编码。接入方若只保留渲染后的纯字符串再自行编码,就可能丢失模板与用户文本的边界。这个机制处理 token 编码问题,语义层的提示词攻击仍需由应用防护。
流式输出也要保留 token 身份。后端把 token ID 交给 parser,parser 就能区分真正的 special token 与拼写相同的普通文本;后端只提供解码后的文本时,部分标记只能按字符串匹配。网络分块也可能把一个标记拆开,例如工具调用标记的前半段和后半段落在不同 chunk。parser 会暂存未完成的尾部,继续识别 reasoning 边界、DSML 工具调用、JSON 内容和 stop 标记,再整理成响应事件。
Recipe 会把模型流中的 tool call 解析成调用事件。应用需要检查参数和用户权限,再决定是否执行;工具返回结果后,应用把结果放回会话并再次请求模型。网页访问、文件读取和命令执行都由调用方授权。库也能把 JSON Schema、regex 等要求转换成 OutputConstraint,但只有实现 constrained decoding 的推理后端才能据此约束生成。接入方还需单独校验 JSON 输出。
图像处理
Recipe 把图片来源和文本 prompt 分开处理。encoding 会记录 image sources,ImageResolver 再调用 fetcher 和图像预处理器,把 URL、data URL 或二进制内容转成模型可用的数据。V4.1 支持图像预处理;V4 不接收图像时,会返回 [Unsupported Image] 占位内容。
图片组件设置了数量、字节和并发预算,默认单个请求最多 600 张,单图 32 MiB、总量 64 MiB,并发解析 8 个 source。普通聊天服务很少需要这么高的限额,实际部署应按业务收紧,同时限制原始 HTTP 请求体大小。
图片 URL 还会带来服务端请求伪造风险。默认 ReqwestImageFetcher 没有目的地址过滤器并会跟随重定向。如果服务端替用户下载图片,恶意 URL 可能被用来探测回环地址、内网服务或云环境元数据端点。Recipe 提供 DestinationFilter 接口,过滤规则由调用方提供;生产服务应校验域名和解析 IP,并在每次重定向后重新检查,配合网络出口限制。
用途与优点
已经有模型后端或在线推理服务的团队,可以用 deepseek-recipe 处理 DeepSeek 协议适配、prompt 编码、图片输入和流式输出。服务端可以保留已有推理后端,只在请求入口与输出出口接入 recipe。比如,一套服务可以同时接收 Chat Completions 和 Messages 客户端,再把它们转换为同一种内部会话,后端不必分别理解每个客户端的字段习惯。
它的主要优点是把模型格式细节集中管理:不同 API 方言有统一转换入口,V4/V4.1 的编码差异由版本选择处理,图片解析和输出流也有对应模块。开发者不必在每个 HTTP handler 里重复手写模板和特殊 token 规则。新增模型版本时,可以集中检查 encoding、special token 和停止条件,再把准备好的输入交给原有推理回调。
仓库附带的 Python FastAPI 和 Rust Axum 服务示例默认接入 mock inference,会返回固定的 “Hello world!”;调用者可以替换成自己的推理回调。示例用于演示服务接入,真实模型推理与认证需由调用方接入。
接入时可以做一组协议契约测试:覆盖普通文本、reasoning、tool call、停止标记被拆到多个 chunk、图片抓取失败和 context 超限等情况。这样能检查应用回调是否遵守 InferenceChunk 的边界,也能发现 API JSON 看起来正确、实际模型提示词却被编码错位的问题。
协议改进小结
从代码看,deepseek-recipe 最有辨识度的改进集中在适配与解析:
- 多协议归一:把 Chat Completions、Responses、Messages 请求整理成内部会话和推理选项。
- 版本化 prompt 编码:分别处理 V4/V4.1 格式,并用
special_ranges保留模板控制 token 与普通文本的边界。- 增量流解析:能够处理 token 身份、跨 chunk 的标记,以及 reasoning、tool call、JSON 和 stop 事件。
- 图片接入组件:解析 URL、data URL 或二进制输入,并提供限额和
DestinationFilter扩展点。这些改进把协议处理集中到适配层;模型计算与工具授权仍由接入服务完成。
组合与上线
如果应用需要同时使用两套代码,接入层可以把 recipe 整理好的 PreparedRequest 和 InferenceOptions 映射到 DeepInfer 的 prompt、图片输入和采样参数,再把引擎输出转换成 recipe 能消费的 InferenceChunk。连接参数、错误处理、取消、并发管理和模型版本映射都需要应用实现;仓库没有提供开箱即用的 adapter。
1 | # 组合方式示意伪代码:adapter 是应用自己写的胶合层 |
部署 DeepInfer 时还要审查模型代码和 profiler 配置。示例 helper create_llm() 默认传入 trust_remote_code=True,调用者可以用 llm_kwargs 覆盖;模型下载调用没有指定 revision。底层 LLM 构造器默认 trust_remote_code=False、revision=None,所以风险来自示例 helper 的默认选择。沿用 helper 加载其他仓库时,远程模型代码可能在推理进程内执行。应固定可信仓库 revision,并检查实际加载的代码。
DeepInfer 的 profiler HTTP 服务默认关闭;显式启用后,会监听 0.0.0.0 上的 6070 + driver GPU ID,端口基数可配置。代码没有认证或 TLS,请求还能指定 trace 输出目录;采集步数默认 20、范围 1 到 50,会占用引擎时间和磁盘空间。是否能从外网访问取决于宿主和容器网络,但生产环境不应把它直接暴露成普通 API。
生产服务需在 API 层配置身份认证、请求限额、图片预算、网络出口和工具权限。Recipe 的图片抓取由调用方提供 DestinationFilter;DeepInfer 的示例服务也需要外层 API 安全控制。
总结建议
DeepInfer 适合离线推理、模型验证和运行时优化,主要价值是对模型执行、调度和缓存有更直接的代码控制。deepseek-recipe 适合 API 协议、提示词、图像和流式输出适配,主要价值是把这些格式细节集中为可嵌入的 Rust 组件。项目章节分别讲清各自用途;需要组合时,再由应用补上 adapter 和生产服务能力。
参考
- DeepSeek:DeepInfer 仓库与代码(commit
8b161497,2026-10-20) - DeepSeek:deepseek-recipe 仓库与代码(commit
935817c,2026-10-20) - DeepSeek:deepseek-recipe Python/Rust server README 与开发文档(2026-10-20)
- DeepInfer 与 deepseek-recipe 代码机制调研材料(固定源码快照及逐项路径,2026-10-20)